Product schema dat AI-systemen echt lezen: zo richt je je productpagina's in

Door Robin Laseur
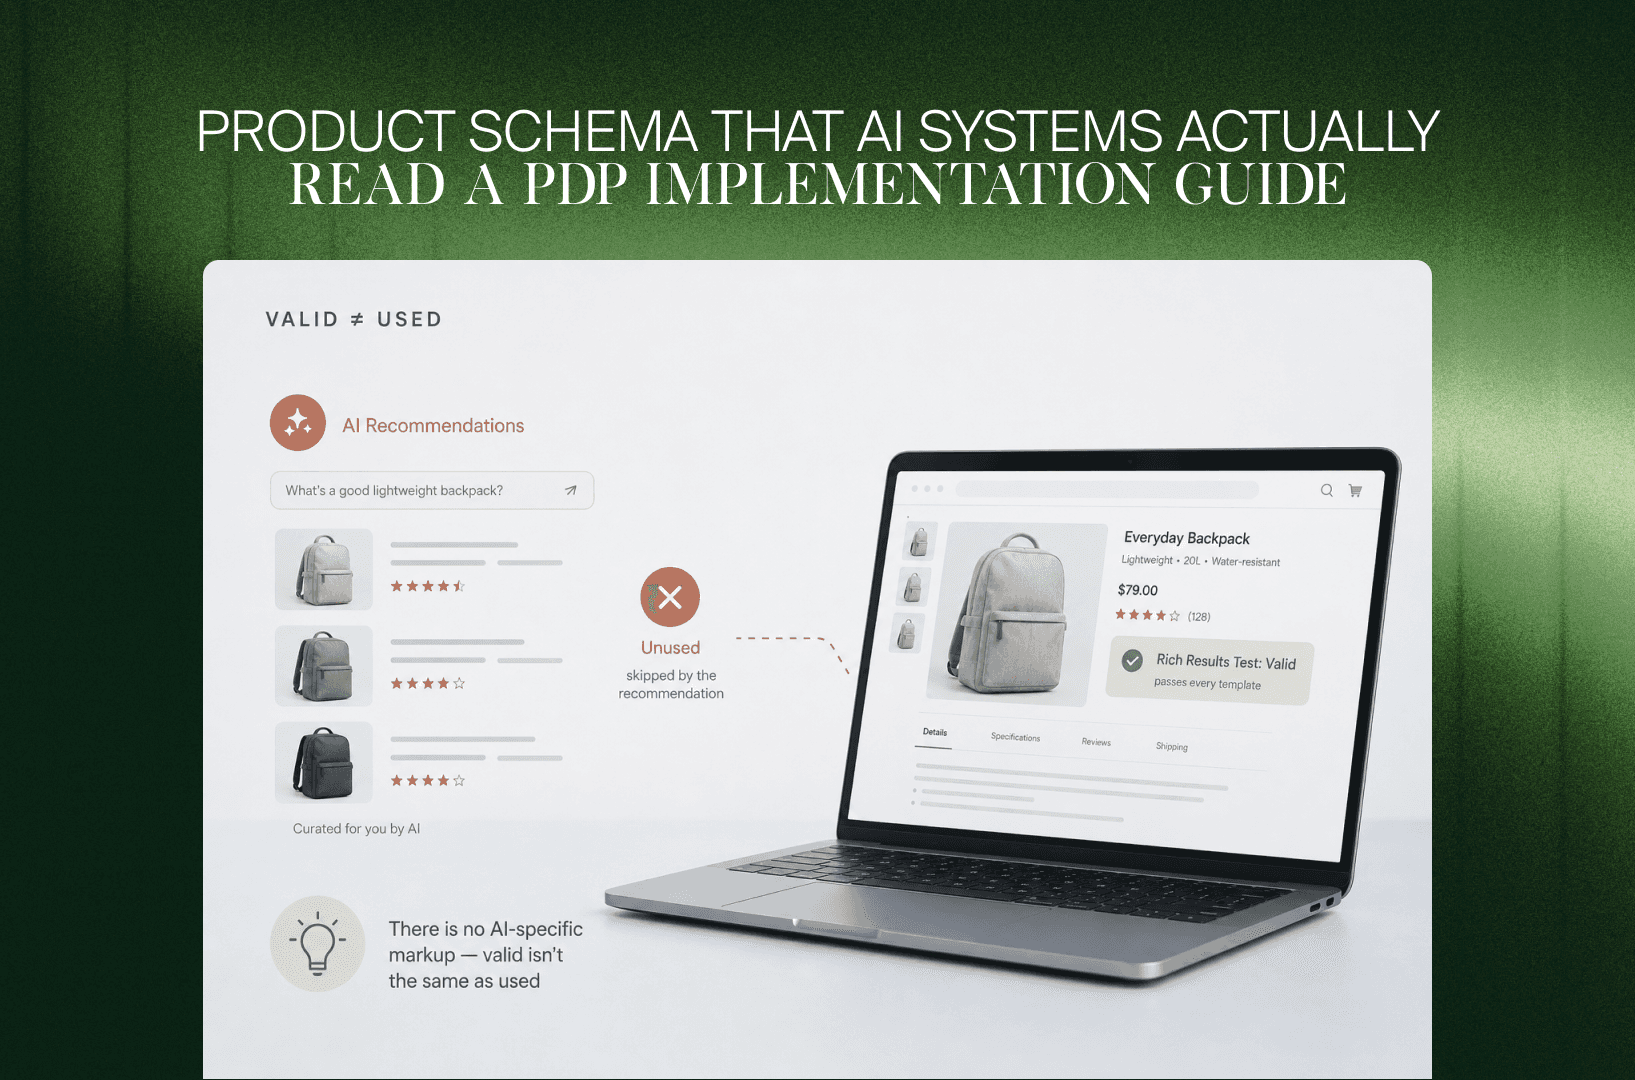
Je catalogus komt op elke template door de Rich Results Test en draagt toch niets bij aan de productaanbevelingen die AI genereert. Dat komt zo vaak voor dat het eerder regel is dan uitzondering. Het gekozen schematype is zelden de oorzaak, en speciale AI-markup die je kunt installeren bestaat niet. Of markup gebruikt wordt of er alleen maar staat, hangt af van drie vragen. Komt de markup überhaupt bij de crawler aan? Staan de productcodes en aanbodgegevens erin die een pagina geschikt maken voor productweergaven? En klopt de markup met de pagina en de feed eromheen?
Hieronder de vier situaties waarin een catalogus kan zitten. Je leest hoe je deze week vaststelt welke op jou van toepassing is, en in welke volgorde je het oppakt. Die volgorde werkt op een webshop met vijfduizend SKU's, niet alleen op een demoproduct.
Wat “schema voor AI-zoeken” eigenlijk betekent
Streep eerst een hele categorie werk weg die alleen in je hoofd bestaat. Google schrijft in AI-functies en je website dat je geen nieuwe machineleesbare bestanden, geen AI-tekstbestanden en geen speciale structured data van schema.org nodig hebt om in die functies te verschijnen. Er is geen AIProduct-type en geen apart markup-dialect voor answer engines. Buiten Google verschilt het per platform hoe goed bevestigd is dat structured data wordt gebruikt. Eerlijk gezegd: voor sommige kanalen is het gedocumenteerd, voor andere niet.
Waar je op kunt rekenen: structured data haalt de twijfel weg. Je legt er machineleesbaar mee vast wat een pagina verkoopt, wat het kost, of het leverbaar is, wie het maakt en welke wereldwijde productcode erbij hoort. Geen enkel systeem verderop hoeft die feiten dan nog uit de lay-out af te leiden. Dat blijft waar, of de lezer nu een zoekindex is, een shoppingkanaal of een model dat een aanbeveling samenstelt.
De documentatie van Google over structured data voor producten deelt het werk op in twee klassen. Die moet je kennen voordat je één regel JSON-LD schrijft. Product snippets zijn bedoeld voor pagina's waar je het product niet direct kunt kopen, met meer ruimte voor reviewinformatie. Merchant listings zijn bedoeld voor pagina's waar klanten bij jou kunnen kopen, met meer ruimte voor productdetails zoals maten, verzending en retouren. Voor een Shopify-webshop is merchant listings jouw klasse. Google merkt op dat pagina's die aan de verplichte producteigenschappen daarvan voldoen, meestal ook in aanmerking komen voor product snippets.
Nog één punt dat bepaalt hoe je dit plant. Volgens Google kom je voor de meeste weergaven in aanmerking als je zowel structured data op de pagina als een Merchant Center-feed aanlevert. Sommige weergaven combineren die twee: product snippets kunnen de prijs uit de feed halen als die in de markup op de pagina ontbreekt. Markup en feed zijn dus geen keuze tussen twee opties. Ze bevestigen elkaar.
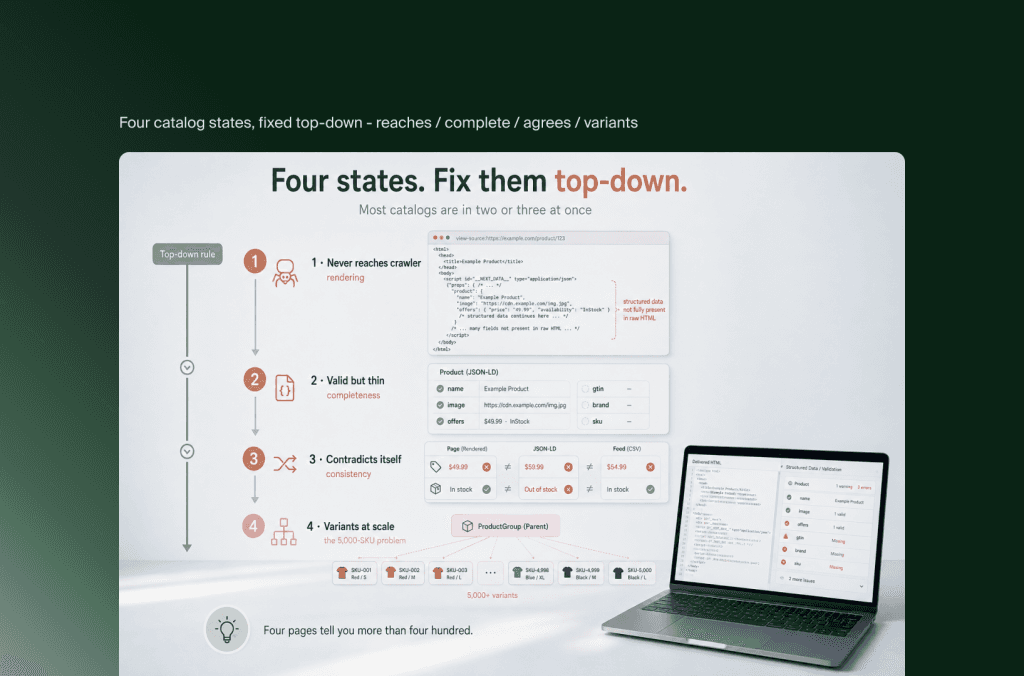
Begin hier: in welke van de vier situaties zit je catalogus
Vier controles, in deze volgorde, laten zien welk deel van het werk voor jou geldt. Elke controle kost een paar minuten op één productpagina en kun je daarna met een script over de hele catalogus draaien.
De meeste catalogi van middelgrote merken zitten in twee of drie van deze situaties tegelijk. Werk ze af in de volgorde hierboven. Een oplossing onderaan levert niets op zolang het probleem bovenaan blijft bestaan.
Als je schema nooit bij de crawler aankomt
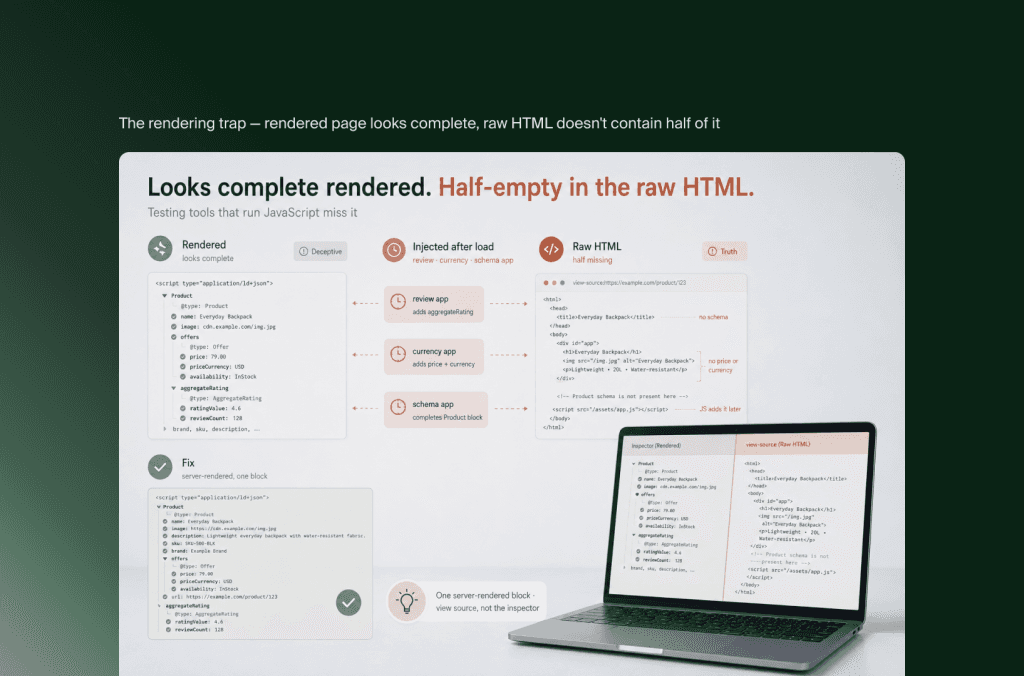
Dit is de situatie achter die specifieke frustratie: geldige markup en geen resultaat. Het is ook de situatie die een testtool het makkelijkst mist, omdat zo'n tool eerst JavaScript rendert en pas daarna controleert.
Op Shopify is het patroon herkenbaar. De basis-markup voor Product zit in het thema en wordt server-side gerenderd. Tot zover geen probleem. Dan voegt een review-app client-side aggregateRating en review aan de pagina toe, herschrijft een personalisatie- of valuta-app de prijs na het laden, en zet een schema-app er een tweede Product-blok bovenop. De gerenderde pagina ziet er compleet uit. In het ruwe document ontbreekt de helft.
Dat heeft twee gevolgen. Systemen die JavaScript uitvoeren, zien de ene versie van je product. Systemen die de geleverde HTML lezen, zien een andere. En juist de productcodes en beoordelingen die het zwaarst wegen voor productweergaven, zitten vaak in de helft die een script nodig heeft. Google publiceert richtlijnen voor het genereren van structured data met JavaScript. Lees ze, juist omdat Google dit behandelt als een geval dat zorg vraagt en niet als een standaard waar je op kunt bouwen.
De oplossing zit in de architectuur, niet in een slimme truc. Zet één Product-blok op de pagina, server-side gerenderd, met elke eigenschap die je gelezen wilt hebben. Dat geldt ook voor de beoordelingen: haal die bij het renderen uit je reviewplatform in plaats van ze achteraf te injecteren. Verwijder dubbele blokken, zodat één object de pagina beschrijft. Test via de paginabron, niet via de inspector.
Als je schema geldig is maar mager
Validatie bevestigt de syntax. Of je genoeg zegt om bruikbaar te zijn, bevestigt ze niet.
De verplichte eigenschappen voor merchant listings draaien om twee dingen: het product identificeren en een volledig aanbod beschrijven. Dus hoe het heet, een afbeelding en een offers-blok met prijs, valuta en beschikbaarheid. Daarmee voldoe je aan het minimum. Met de aanbevolen eigenschappen kom je voor meer in aanmerking, en het zijn ook die eigenschappen waarmee een product aansluit op wat een shopper zoekt: wereldwijde productcodes zoals gtin, het merk (brand), de sku, reviews en beoordelingen als je echte reviews hebt, en de uitbreidingen voor verzendgegevens en retouren. Google raadt daarnaast aan je bedrijfsbeleid vast te leggen in Organization-markup, waaronder je retourbeleid en, als je er een hebt, de details van je loyaliteitsprogramma.
De praktische regel voor een grote catalogus: behandel productcodes als verplicht, ook al noemt de specificatie ze aanbevolen. Een product zonder gtin en brand is moeilijk te koppelen aan hetzelfde product elders. En juist door die koppeling tussen bronnen wordt een product gezien als één ding waar een systeem zeker van is, in plaats van meerdere waar het aan twijfelt.
Blaas niets op. Rating-markup zonder echte reviews erachter, of specificaties die je verzint om een veld te vullen, leveren precies de tegenstrijdigheden op die hierna aan bod komen.
Als je data zichzelf tegenspreekt
Elke Shopify-webshop van een middelgroot merk beschrijft elk product op minstens drie plekken: de paginatekst, de JSON-LD en de Merchant Center-feed. Een vierde komt erbij zodra een ERP of PIM een van die drie voedt. Zolang niets ze dwingt gelijk te blijven, lopen ze uit elkaar.
De verschillen zijn meestal alledaags, en ze kosten geld. Valuta en prijs wijken per markt af, omdat het schema de hoofdmarkt vast in de code heeft staan terwijl de pagina gelokaliseerde prijzen toont. De markup zegt ‘op voorraad’ terwijl de pagina een uitverkochte variant laat zien. De producttitel in de feed heeft een toevoeging per kanaal die de pagina niet gebruikt. Een productcode staat wel in de feed en niet op de pagina.
Google zegt dat sommige weergaven markup op de pagina combineren met feeddata. Overeenstemming tussen die twee is dus geen opruimwerk. Het bepaalt of het gecombineerde beeld klopt. Wijs per veld één leidend systeem aan: meestal het platform voor prijs en beschikbaarheid, en de PIM voor kenmerken en productcodes. Laat elk ander kanaal daaruit putten in plaats van een eigen kopie bij te houden.
Varianten en schaal: het probleem van vijfduizend SKU's
Hier onderscheidt een demo-implementatie zich van een die werkt. De meeste handleidingen gaan er nauwelijks op in.
Een productpagina met tien maten en vier kleuren kan op drie manieren markup meegeven. Eén algemeen Product-object dat geen van de opties beschrijft: dat zie je vaak, en om te matchen is het vrijwel nutteloos. Veertig losse Product-objecten, wat eruitziet als duplicatie. Of een benoemd hoofdproduct met de varianten eraan gekoppeld. Daarvoor is de structured data voor productvarianten van Google bedoeld. Je geeft ermee aan welke producten variaties zijn van hetzelfde hoofdproduct, en zowel product snippets als merchant listings ondersteunen het.
De opbouw ziet er ongeveer zo uit. Controleer de exacte set eigenschappen in de variantdocumentatie van Google voordat je live gaat, want de specificatie is gedetailleerder dan welk voorbeeld ook:
{
“@context”: “https://schema.org/”,
“@type”: “ProductGroup”,
“name”: “Trail Runner Jacket”,
“brand”: { “@type”: “Brand”, “name”: “Example Brand” },
“productGroupID”: “TRJ-001”,
“variesBy”: [“https://schema.org/size”, “https://schema.org/color”],
“hasVariant”: [
{
“@type”: “Product”,
“sku”: “TRJ-001-M-BLK”,
“gtin13”: “0000000000000”,
“size”: “M”,
“color”: “Black”,
“offers”: {
“@type”: “Offer”,
“price”: “189.00”,
“priceCurrency”: “EUR”,
“availability”: “https://schema.org/InStock”
}
}
]
}
Op de schaal van een hele catalogus wordt de vraag hoe je het modelleert een operationele vraag: waar staan de waarden van je variantkenmerken nu eigenlijk in je webshop? Op Shopify zijn ze meestal verspreid over de standaard variantopties, metavelden en losse beschrijvingstekst. Alleen de eerste twee kun je betrouwbaar via een template in markup omzetten. Een kenmerk dat alleen in lopende tekst staat, moet eerst naar een metaveld voordat je het als structured data kunt uitdrukken. Bij een catalogus van vijfduizend SKU's is die migratie het eigenlijke project, niet de JSON-LD.
Daarom begint de volgorde hieronder bij de data en niet bij de templates.
Implementatievolgorde en de controlelus
Zeven stappen, in de volgorde die het minste herstelwerk oplevert.
Breng de huidige situatie in kaart met alle vier controles, op een representatieve steekproef: een eenvoudig product, een product met meerdere varianten, een bundel en een product met reviews. Vier pagina's vertellen je meer dan vierhonderd.
Los eerst de rendering op. Breng alles terug tot één server-side gerenderd Product- of ProductGroup-blok per pagina en verwijder dubbele of client-side geïnjecteerde blokken. Niets anders telt zolang je markup niet in de ruwe bron staat.
Koppel velden aan bronnen. Bepaal per eigenschap welk systeem de eigenaar is. Leg dat vast in een tabel die je developers en je merchandisers allebei lezen.
Verplaats kenmerken die alleen in tekst staan naar metavelden, te beginnen met de kenmerken waarop kopers in jouw categorie echt filteren. Dit is de trage stap, en ook de stap die zich in elk kanaal terugbetaalt.
Zet de markup in een template, inclusief varianten, en vul productcodes eerst in bij de SKU's die de meeste omzet maken, niet op alfabetische volgorde.
Leg pagina, markup en feed naast elkaar voor een steekproef per producttype. Los verschillen op bij de bron in plaats van de uitvoer op te lappen.
Maak de lus rond. Valideer met de Rich Results Test op templateniveau en volg daarna de structured data-rapporten in Search Console op catalogusniveau. Een test per template laat namelijk niet zien bij welk producttype een veld leeg binnenkomt.
Zie stap zeven als terugkerend werk. Thema's krijgen updates, apps veranderen hoe ze markup injecteren, en een merchandiser die een nieuw producttype toevoegt, vult velden in die niemand heeft gedocumenteerd. Structured data gaat ongemerkt achteruit, en het rapport dat dat zichtbaar maakt, heeft geen eigenaar.
Wil je verder lezen over hoe Google dit terrein benadert? De handleiding van Google voor optimalisatie voor generatieve AI-zoekfuncties hoort bij de documentatie over structured data waar dit artikel steeds naar verwijst.
Weet je niet zeker of je productmarkup echt aankomt bij de systemen die hem lezen? Flatline is Shopify Platinum Partner, en audits van structured data horen bij ons technische werk voor catalogi van deze omvang. Neem contact op, dan lopen we het samen met je door.
Veelgestelde vragen
Bestaat er een speciaal schematype voor AI-zoeken?
Nee. Volgens de documentatie van Google heb je voor de AI-functies geen nieuwe bestanden of speciale structured data van schema.org nodig, en een apart markup-dialect voor answer engines bestaat niet. Gebruik het standaard Product-vocabulaire, volledig en consequent ingevuld. Of markup wordt gebruikt of niet, hangt af van rendering, volledigheid en overeenstemming met je andere databronnen.
Zegt de Rich Results Test of mijn schema goed genoeg is?
Hij zegt of je markup geldig is en voor welke rich results die in aanmerking komt. Hij zegt niet of de markup als geleverde HTML bij de crawler is aangekomen, of je productcodes compleet zijn en of de waarden kloppen met je feed. Controleer de ruwe paginabron apart, en leg alles naast Merchant Center in plaats van alleen op validatie te vertrouwen.
Heb ik voor elk product een GTIN nodig?
Google noemt productcodes aanbevolen, niet verplicht. Maar voor een catalogus die meedingt naar productaanbevelingen zijn ze in de praktijk onmisbaar. Via productcodes wordt hetzelfde product uit verschillende bronnen samengevoegd tot één product waar een systeem zeker van is. Verkoop je eigen producten zonder GTIN? Vul dan brand, sku en mpn consequent in.
Hoort schema in het thema of in een app?
In het thema, server-side gerenderd, voor alles wat betrouwbaar gelezen moet worden. Apps zijn handig, maar injecteren markup vaak pas na het laden van de pagina of voegen een tweede, concurrerend Product-blok toe. Is een app je enige praktische optie? Controleer dan of de output in de geleverde HTML staat en of die niet het blok dupliceert dat je thema al meegeeft.
Kort samengevat
Een product schema speciaal voor AI bestaat niet. Het standaard Product-vocabulaire, volledig ingevuld, is alles wat je hebt en nodig hebt. Rendering, volledigheid en consistentie bepalen of het gebruikt wordt.
Markup die pas verschijnt nadat JavaScript is uitgevoerd, is onzichtbaar voor systemen die geen scripts draaien. Breng alles terug tot één server-side gerenderd blok per pagina en controleer via de paginabron, niet via de inspector.
Productcodes zijn officieel aanbevolen en in de praktijk onmisbaar. Via brand, GTIN en SKU wordt hetzelfde product op de pagina, in de feed en bij externe bronnen samengevoegd tot één product waar een systeem zeker van is.
Bij een grote catalogus is het echte project het verplaatsen van kenmerken uit lopende tekst naar gestructureerde velden. De JSON-LD-template is een week werk. De datamigratie eronder is het deel dat zich in elk kanaal terugbetaalt.
Productmarkup beloont geduld, niet slimheid. Een catalogus met complete, kloppende, server-side gerenderde data voor de duizend belangrijkste SKU's staat sterker dan een catalogus met uitgebreide markup op alle vijfduizend en in elk derde veld een tegenstrijdigheid.
Gerelateerde artikelen


