De AI-zichtbaarheidsaudit: waar je merk staat in ChatGPT, AI Overviews en Perplexity

Door Robin Laseur

De meeste gepubliceerde AI-zichtbaarheidsaudits leveren één cijfer op, ergens tussen nul en honderd. Van alles wat zo’n audit kan opleveren is dat cijfer het minst bruikbaar, want het schuift twee losse vragen in elkaar en achter allebei zit een ander traject. Wat AI-systemen nu over je merk zeggen: dat is de ene audit. Of je site ze iets bruikbaars te zeggen geeft: dat is de andere. Een merk kan op het eerste punt slecht scoren terwijl het tweede prima op orde is, en dan is wat je daarna moet doen in beide gevallen niet hetzelfde.
Dit is de versie die wij als nulmeting draaien: een vaste promptset, drie metingen per platform, drie assen die je los van elkaar scoort, en vier situaties die elk een andere kant op sturen. Het kost een dag geconcentreerd werk en geen betaalde tools. Wat je overhoudt is een benchmark met een datum erbij: hard genoeg voor een directieoverleg en concreet genoeg om binnen negentig dagen te verslaan.
Wat deze audit beantwoordt en wat niet
De audit aan de antwoordkant meet wat gegenereerde antwoorden nu zeggen: of je merk genoemd wordt bij de vragen die je kopers stellen, of de omschrijving klopt, en uit welke bronnen het antwoord is opgebouwd. Die vertelt je waar je staat.
De audit aan de sitekant meet of AI-systemen je pagina’s kunnen bereiken en lezen: toegang voor crawlers, rendering, volledigheid van je productdata, gestructureerde data. Die vertelt je waarom. Flatline publiceert een gratis AI readiness-analyse die precies die sitekant nagaat en een rapport teruggeeft met scores en een geordende lijst verbeterpunten. Dat loopt goed samen met wat hier volgt.
Doe je alleen de sitekant, dan krijg je een lijst technisch werk zonder bewijs welk punt er nu echt in de weg zit. Doe je alleen de antwoordkant, dan krijg je een oordeel zonder uitleg. De volgorde die werkt is: eerst de antwoordkant, want die wijst aan welke technische bevinding ertoe doet, en daarna de sitekant om het gat te verklaren.
Nog één afbakening voordat je begint. Deze audit levert een benchmark op, geen voorspelling. Gegenereerde antwoorden verschillen per keer, dus de eerlijke uitkomst is een bandbreedte met een datum en niet een precies cijfer.
Bouw je meetinstrument
Twintig tot veertig prompts, door jou geschreven, in de woorden die je kopers gebruiken. Een promptset die je laat genereren is sneller klaar en minder waard, want juist dit instrument moet kwartaal na kwartaal hetzelfde blijven.
Haal ze uit vier hoeken. Je zoekwoorddata, voor de vragen die mensen al in woorden stellen. Je sales- en supportgesprekken, voor de voorwaarden die kopers echt noemen. De vergelijkingstaal van je categorie, want in vergelijkingsvragen vallen de aanbevelingen. En je eigen merknaam, om te testen wat systemen over je zeggen als je het rechtstreeks vraagt.
Dek vier soorten prompts af, ongeveer in deze verhouding:
Categorie-aanbeveling (ongeveer de helft): “beste [producttype] voor [gebruikssituatie]”, met de voorwaarden die je kopers echt stellen, inclusief prijsklassen en specifieke omstandigheden.
Vergelijking (ongeveer een kwart): jouw merk tegenover een concurrent met naam, en alternatieven voor die concurrent.
Eigenschap en geschiktheid (ongeveer een vijfde): “is [materiaal of functie] goed voor [situatie]”, de vragen die een aankoop beslissen in plaats van hem te starten.
Merk direct (de rest): wat is je bedrijf, wat verkoopt het, voor wie is het.
Zet de set vast en geef hem een versienummer. Elke vergelijking die je later maakt, valt of staat met een bestand dat niet verandert.
Het meetprotocol
Vier regels. De derde slaan de meeste audits over.
Kies drie platforms en leg vast welke. Google AI Overviews en AI Mode, ChatGPT, en daarnaast Perplexity, Gemini of Copilot, afhankelijk van waar je kopers echt zitten. Meer platforms is meer werk zonder dat een nulmeting er scherper van wordt.
Werk in een schone sessie. Uitgelogd of in een vers profiel, met de locatie op je belangrijkste markt. Zo meet je het systeem en niet je eigen geschiedenis.
Stel elke prompt drie keer per platform. Dat is het verschil tussen een meting en één willekeurige greep uit een proces dat varieert. Noteer alle drie de uitkomsten, niet de mooiste.
Zet overal een datum bij en leg de bronnen vast. Bewaar per antwoord welke merken genoemd werden, in welke volgorde, en op welke URL’s het antwoord leunde. De bronnenkolom levert de data waarmee je het snelst iets kunt.
Het scoreformulier
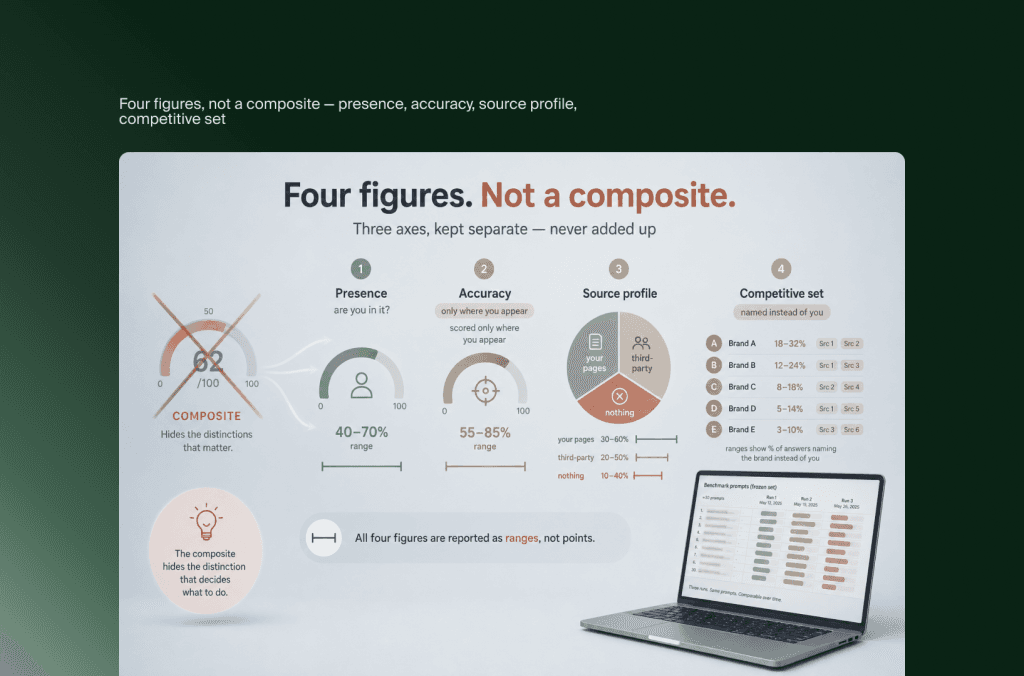
Scoor elke prompt op drie assen. Houd ze uit elkaar en tel ze niet op tot één cijfer.
Maak daarna vier getallen, elk als gemiddelde over je hele promptset, met de spreiding tussen de metingen ernaast.
Gemiddelde aanwezigheid, die beantwoordt of je überhaupt in het gesprek zit.
Gemiddelde juistheid, alleen gescoord op prompts waarin je voorkwam, die beantwoordt of dat meedoen je ook iets oplevert.
Bronprofiel, dat laat zien of aanbevelingen op je eigen pagina’s rusten, op derden, of op iets wat niets met jou te maken heeft.
Concurrentieveld, oftewel de drie tot vijf merken die het vaakst in jouw plaats verschijnen, en de bronnen die bij die antwoorden stonden.
Vier getallen dus, geen één. Het samengestelde cijfer dat de meeste audits rapporteren verbergt precies het onderscheid dat bepaalt wat je nu moet doen.
Vier situaties, en hoe je de jouwe herkent
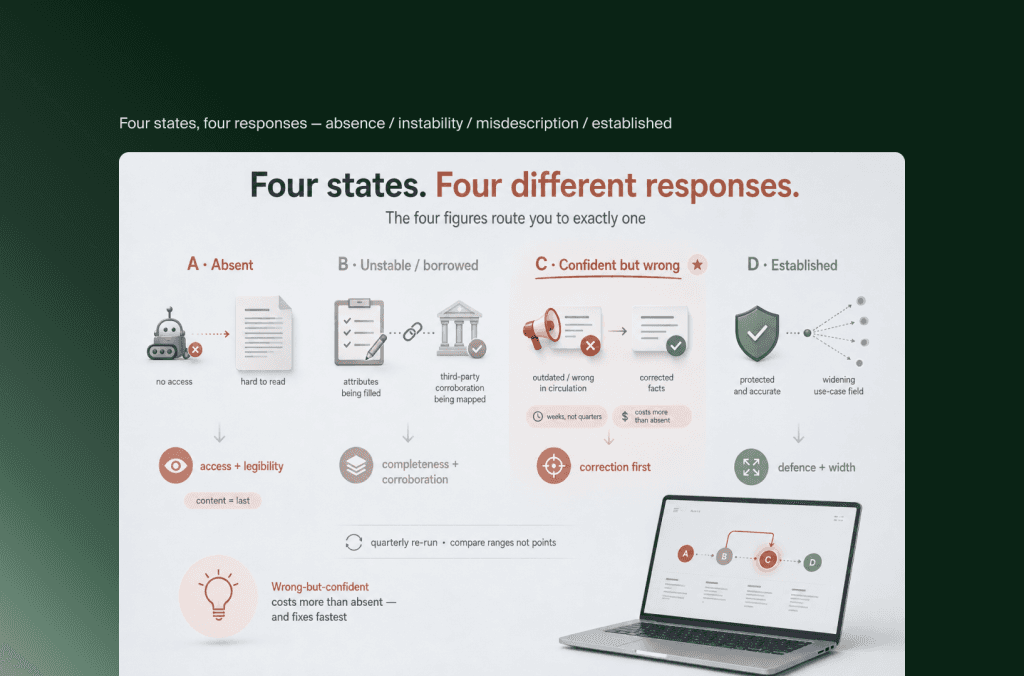
Situatie C verdient een aparte opmerking, want die verrast teams. Een stellige maar onjuiste omschrijving die door gegenereerde antwoorden rondgaat, kost je meer dan helemaal niet genoemd worden: een klant gaat erop af, komt binnen met de verkeerde verwachting, en de rekening voor die correctie belandt bij je supportteam. Tegelijk is dit meestal de snelste van de vier om op te lossen, want de oorzaak is vaker verouderde openbare informatie dan een structureel gat.
Twijfelgevallen
Drie gevallen zitten tussen twee situaties in, en ze lossen alle drie op dezelfde manier op.
Sterk op het ene platform, afwezig op het andere
Scoor ze apart in plaats van het gemiddelde te nemen. Verschil tussen platforms is een bevinding, geen ruis: meestal betekent het dat het ene systeem je site leest terwijl het andere leunt op bronnen van derden waarin jij ontbreekt.
Wel aanwezig, maar alleen bronnen van derden worden genoemd
Behandel dit als situatie B, hoe hoog je gemiddelde aanwezigheid ook is. Zichtbaarheid die volledig op de pagina’s van anderen rust is echt en geleend tegelijk, en ze beweegt mee zodra hun content beweegt.
Overal juist, behalve bij prijs en voorraad
Dit is geen contentprobleem. Als prijs en voorraad gaan schuiven, spreken je gestructureerde data, je feed en je pagina elkaar tegen. Dat is een klus in het gelijktrekken van data en niet in zichtbaarheid.
Wat elke situatie vraagt
Situatie A
Begin bij toegang en leesbaarheid, in die volgorde. Controleer of AI-crawlers volledige responses krijgen op je product- en categorietemplates, want een half antwoord levert stilletjes precies dit resultaat op. Kijk daarna of je pagina’s de feiten over je producten gewoon in tekst zetten en ze niet wegstoppen in tabs, afbeeldingen en variantkiezers. Content maken is hier de laatste stap, niet de eerste.
Situatie B
Volledigheid en bevestiging van buitenaf. Vul de productattributen aan op de SKU’s die je omzet dragen, want als je producten maar half matchen met de voorwaarden van kopers, kom je ook maar half in beeld. Breng ondertussen in kaart welke bronnen van derden in de antwoorden worden genoemd, en begin aan het trage werk om daarin te verschijnen.
Situatie C
Eerst corrigeren. Zoek uit waar de verkeerde informatie staat: je eigen verouderde pagina’s, oude profielen bij derden, of vermeldingen in gidsen die sinds een rebranding niemand meer heeft aangeraakt. Zorg dat de huidige feiten makkelijk te vinden zijn en overal hetzelfde staan. Dit is vaak een kwestie van weken en niet van kwartalen.
Situatie D
Verdedigen en verbreden. Rek je promptset op naar aangrenzende gebruikssituaties, houd bij of concurrenten je verdringen bij bepaalde voorwaarden, en houd je bronprofiel gezond, zodat je positie niet op het lijstje van één uitgever rust.
Draai de hele audit elk kwartaal opnieuw, tegen dezelfde vastgezette promptset, en vergelijk bandbreedtes in plaats van punten. Een gemiddelde aanwezigheid die van 0,9 naar 1,4 gaat terwijl de bandbreedtes elkaar overlappen is bemoedigend en nog geen bewijs; dezelfde stap met bandbreedtes die los van elkaar liggen is een resultaat.
Wat we bewust hebben weggelaten
In deze methode staan geen benchmarkpercentages, en dat is een keuze. De cijfers die rondgaan over wat een gezond aandeel vermeldingen zou zijn, komen uit onderzoek van leveranciers met promptsets die ze niet publiceren, en een benchmark die je niet kunt nabootsen is geen benchmark. Je eerste meting met datum is je nulmeting. Die moet je verslaan.
Ook geen samengesteld cijfer, om de reden die bovenaan staat: het getal dat een slide overtuigend laat lijken is precies het getal dat de informatie weghaalt die je nodig hebt om iets te doen.
Bouw je dit instrument liever niet zelf, dan is dit de nulmeting die Flatline draait aan het begin van een GEO-traject. We zijn Shopify Platinum Partner met een team voor AI-advies en technische SEO. Je krijgt een benchmark met datum, de vier scores, je concurrentieveld met de bronnen die erbij genoemd werden, en een verbeterplan op volgorde van belang, toegesneden op de situatie waarin je blijkt te zitten. Vraag de audit aan, dan draaien wij de nulmeting en lopen we met je door wat die betekent voor jouw assortiment.
Veelgestelde vragen
Hoelang duurt een AI-zichtbaarheidsaudit?
Een dag geconcentreerd werk voor een set van twintig tot veertig prompts op drie platforms, elk drie keer gesteld, plus een paar uur om te scoren en uit te schrijven. Voor het bouwen van de promptset mag je de tijd nemen, want elke latere vergelijking hangt ervan af dat die set niet verandert.
Heb ik een betaalde AI-zichtbaarheidstool nodig?
Nee. De methode hierboven werkt met de platforms zelf en een spreadsheet. Betaalde tools worden pas nuttig voor frequentie en schaal, als je eenmaal een nulmeting hebt en doorlopend wilt meten in plaats van per kwartaal. Ze leggen een gemakslaag over deze methode heen en vervangen haar niet.
Waarom scoor je aanwezigheid en juistheid apart?
Omdat ze om ander werk vragen. Afwezigheid wijst meestal op toegang, leesbaarheid of ontbrekende bevestiging van buitenaf. Een onjuiste omschrijving wijst op verouderde informatie die nog rondgaat. Één gecombineerd cijfer zet een merk dat veel genoemd wordt maar verkeerd beschreven staat in dezelfde categorie als een merk dat niemand noemt, en stuurt ze allebei hetzelfde verbeterplan.
Hoe vaak moet je de audit herhalen?
Elk kwartaal, tegen de vastgezette promptset, met elke keer de datum erbij. Vaker meten legt vooral de variatie vast en niet de vooruitgang, want gegenereerde antwoorden verschillen al binnen één week. Doe het eerder als je van platform wisselt, rebrandt of de structuur van je assortiment ingrijpend verandert.
Kort samengevat
Draai twee audits, geen één. De antwoordkant vertelt je waar je staat, de sitekant vertelt je waarom. De antwoordkant gaat voorop, want die wijst aan welke technische bevindingen er echt toe doen.
Rapporteer vier getallen in plaats van één samengesteld cijfer: aanwezigheid, juistheid, bronprofiel en concurrentieveld. Dat ene cijfer verbergt precies het onderscheid dat bepaalt wat je nu doet.
Drie metingen per prompt, met datum en met de spreiding erbij. Één getal uit één keer draaien van een systeem dat varieert, is geen meting.
Vier situaties vragen om vier verschillende antwoorden. Afwezigheid wijst naar toegang en leesbaarheid, wisselvalligheid naar volledigheid en bevestiging van buitenaf, een verkeerde omschrijving naar correctie, en een gevestigde positie naar verdedigen en verbreden.
Deze audit is het waard, ook als er niet meteen iemand mee aan de slag gaat, want die nulmeting met datum kun je later niet meer reconstrueren. Over een half jaar is de vraag of de positie is verbeterd, en die vraag is alleen te beantwoorden als iemand heeft opgeschreven waar het begon.
Gerelateerde artikelen


