llms.txt, Web Bot Auth en crawlerbeleid: de toegangslaag van AI-zoeken

Door Robin Laseur
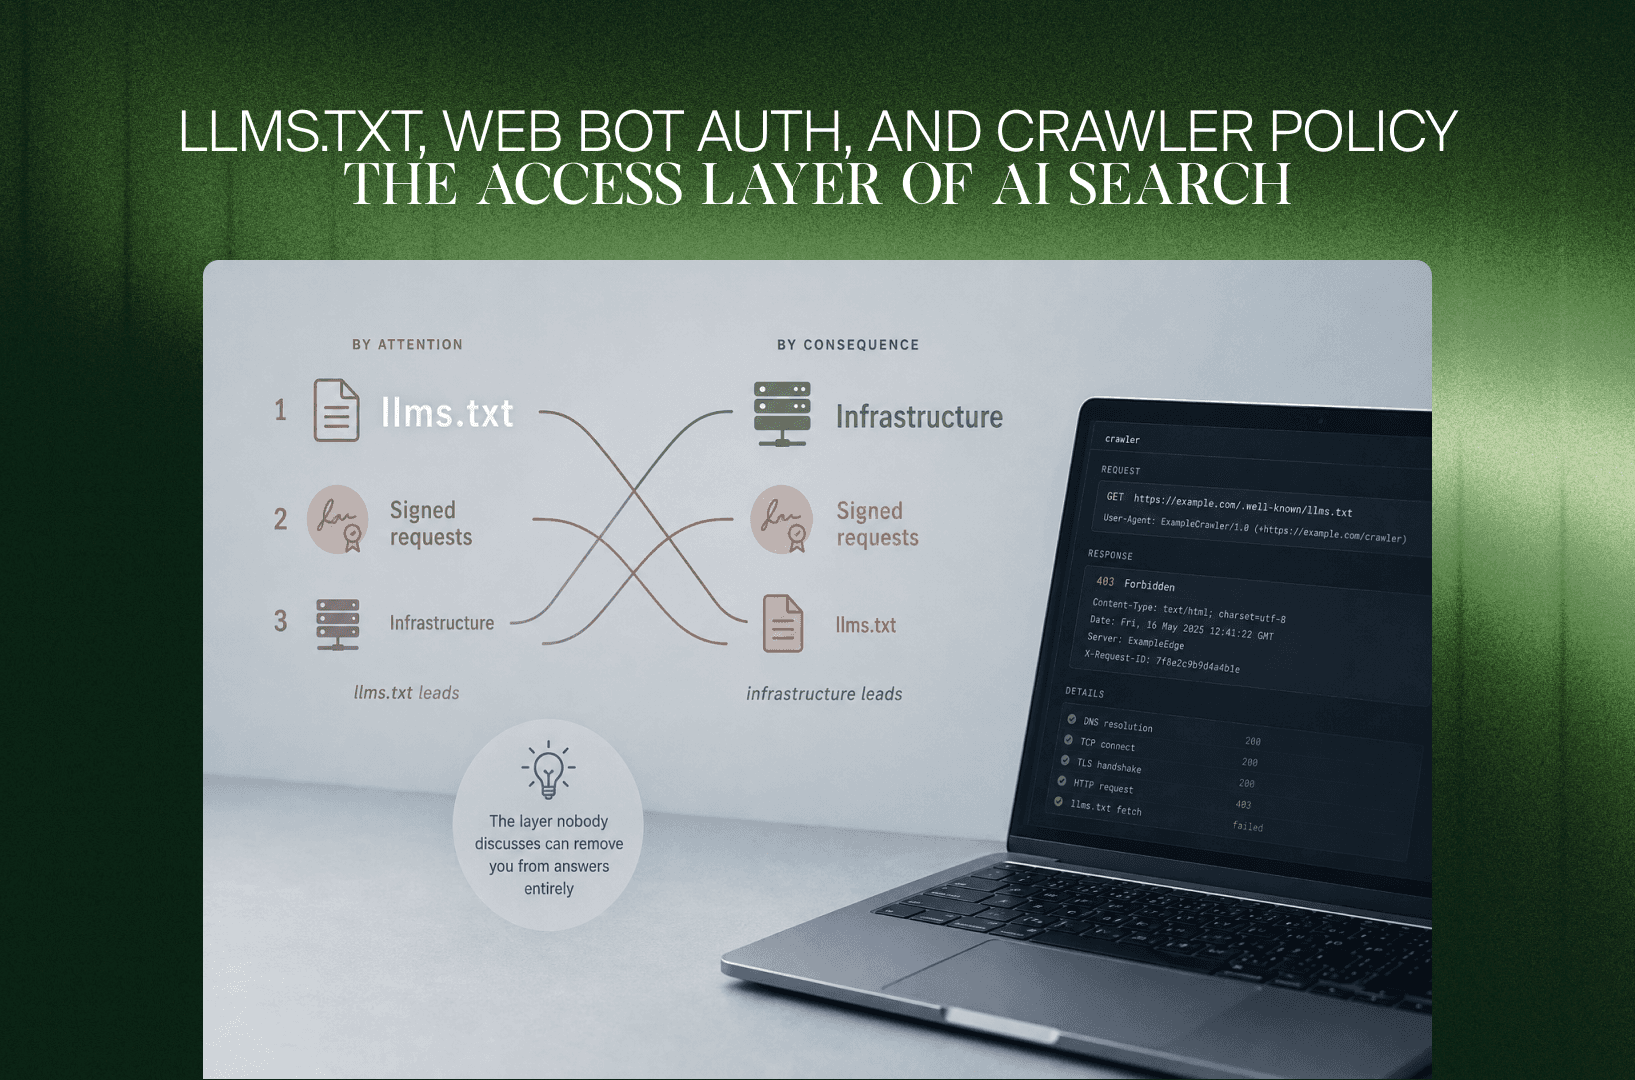
De toegangslaag is het stuk AI-zoekwerk dat in de praktijk wordt bepaald door wie er als laatste aan de firewall heeft gezeten. Voor de meeste eCommerce-teams bestaat die laag uit drie dingen die zich totaal verschillend gedragen: een bestand waar iedereen over praat en dat bijna geen enkel systeem leest, een set infrastructuurregels die stilletjes bepalen of AI-crawlers je catalogus überhaupt bereiken, en een mechanisme met ondertekende verzoeken dat uitmaakt welke geautomatiseerde bezoekers als legitiem worden behandeld. Op aandacht gemeten staat llms.txt bovenaan. Op gevolgen voor een productcatalogus gemeten staat het onderaan.
Die omkering is een middag van je tijd waard. De laag waar niemand het over heeft, is namelijk de laag die je webshop volledig uit gegenereerde antwoorden kan halen.
De verwachting: llms.txt als de robots.txt van het AI-tijdperk
De redenering klopt op het eerste gezicht. Zoekmachines lezen robots.txt, dus zouden AI-systemen een vergelijkbaar bestand moeten lezen. Een samengestelde Markdown-index van je belangrijkste pagina’s klinkt precies als wat een model wil hebben: minder ruis, geen tokens die opgaan aan navigatie en cookiebanners, en een helder overzicht van wat de site is en waar de inhoud staat.
Het voorstel zelf is doordacht. Het komt van Jeremy Howard van Answer.AI, september 2024, en was bedoeld om taalmodellen te helpen een website te gebruiken op het moment dat ze een antwoord samenstellen. Serieuze bedrijven publiceren er een. Zo’n bestand online zetten kost minder dan een uur. Alles bij elkaar leidt dat tot een redelijke conclusie, en daarom staat het bij zoveel eCommerce-teams op de roadmap.
Wat het onderzoek laat zien
Het standpunt van Google staat zwart op wit; je hoeft het niet af te leiden. In de richtlijn over AI-functies en je website staat dat er geen nieuwe machineleesbare bestanden, AI-tekstbestanden of speciale schema.org-data nodig zijn om in die functies te verschijnen. De handleiding voor optimalisatie voor generatieve AI-zoekresultaten kreeg in juni 2026 een update met dezelfde boodschap over speciale bestanden. Mensen uit het Google Search-team zeggen dat sinds 2025 ook openlijk.
De onafhankelijke cijfers wijzen dezelfde kant op. SE Ranking onderzocht 300.000 domeinen, een studie die dit jaar breed is opgepikt, en kwam uit op een adoptie van ongeveer tien procent. Het bureau bouwde een model om te testen of de aanwezigheid van een llms.txt-bestand samenhangt met hoe vaak een site wordt geciteerd; toen het bestand uit het model werd gehaald, werd de voorspelling juist beter. De variabele gedroeg zich dus als ruis, niet als signaal. Ander onderzoek, gerapporteerd door Originality.ai, liet zien dat de adoptie hard groeide terwijl het overgrote deel van de gepubliceerde bestanden nooit door een AI-systeem is opgehaald.
Er is één echte complicatie, en die zit binnen Google zelf. Lighthouse in Chrome kreeg in mei 2026 een audit voor agentic browsing die controleert op llms.txt, precies in de periode waarin Search Central aan site-eigenaren vertelde dat het bestand niet nodig is. Beide teams hebben gelijk binnen hun eigen kader, want ze beschrijven verschillende afnemers: een zoekindex aan de ene kant, agentic browsers en coding assistants aan de andere.
En dat is precies de samenvatting die klopt. De systemen die llms.txt vandaag aantoonbaar lezen, zijn gericht op ontwikkelaars: coding assistants die documentatie ophalen, agent-frameworks en een aantal crawlers die adoptie meten. Beweringen dat specifieke AI-zoekproducten voor consumenten het bestand ophalen, spreken elkaar tegen en zijn door de aanbieders zelf nooit bevestigd. Verkoop je producten, dan is dat gebruik niet jouw gebruik.
Waar het gat vandaan komt
Drie mechanismen verklaren waarom een idee dat zo redelijk klinkt zo weinig oplevert.
Een bestand dat je zelf invult, wordt door niemand gecontroleerd. Een document waarin een site zelf verklaart waar hij over gaat, zonder dat iets die claim toetst, heeft een duidelijke voorganger: de keywords meta tag. Elk systeem dat erop leunt, haalt een input binnen die te manipuleren is. Retrieval-systemen hebben al een sterkere bron: de pagina’s zelf, gecrawld en beoordeeld.
Het probleem dat het oplost, is een documentatieprobleem. Zuinig omgaan met tokens telt enorm als een agent API-documentatie leest om code te schrijven. De vraag van een shopper wordt beantwoord met productdata, reviews en categoriecontent die de retrieval-pijplijn allang verwerkt. De pijn die llms.txt wegneemt is echt, maar die voelen bedrijven in developer tools, niet webshops met een catalogus.
Niemand handhaaft het. Er zit geen standaardisatie-instituut achter het formaat en geen enkele aanbieder is verplicht zich eraan te houden. Daarom lopen de cijfers over adoptie uiteen en moet je van elke aanbieder het gedrag meten in plaats van aannemen.
Dat maakt publiceren nog niet verkeerd. Het maakt het een goedkope oefening met lage verwachtingen, die niet bovenaan een commerce-roadmap thuishoort.
Wat de toegangslaag echt bepaalt
Dit is de laag die de uitkomst bepaalt, met per mechanisme wat het precies regelt.
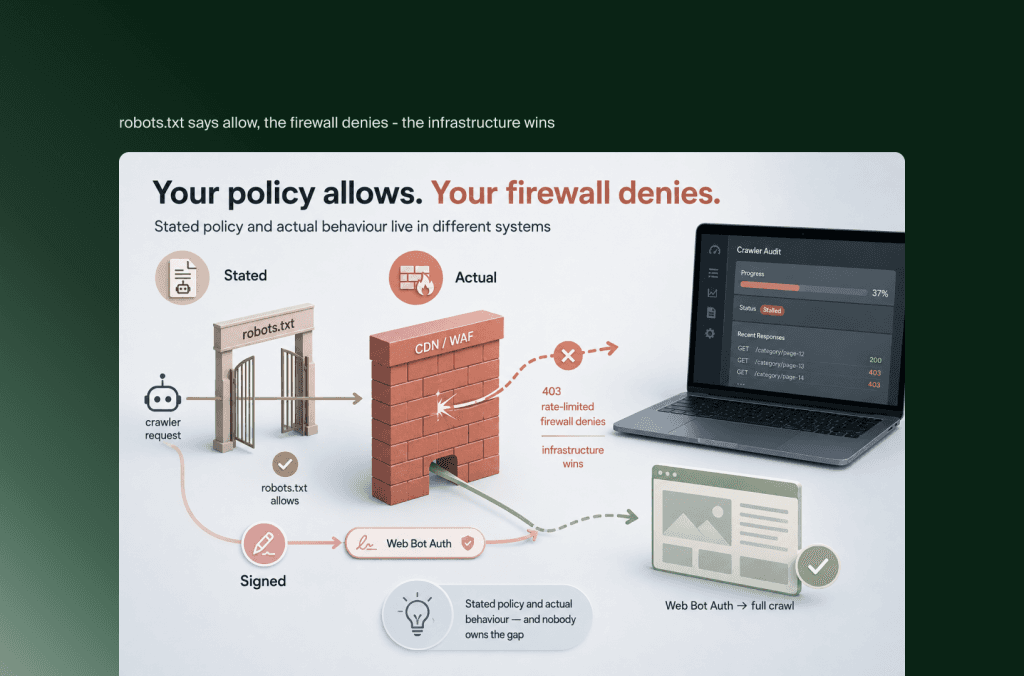
De tweede regel is de regel met gevolgen. Beleid en gedrag lopen voortdurend uit elkaar: een robots.txt die een AI-crawler toelaat, betekent niets als de beveiligingslaag ervoor datzelfde verzoek weigert. Teams ontdekken dat als ze hun eigen site willen auditen, wanneer een grote crawl van een Shopify-winkel vastloopt op rate-limitreacties die in een rapport lezen als een contentprobleem en in werkelijkheid uit de beveiligingslaag komen. Sinds Shopify ondertekende crawlerverzoeken via Web Bot Auth ondersteunt, is die handtekening het verschil tussen een volledige en een halve audit. Onze uitleg over Screaming Frog op Shopify laat zien hoe je dat instelt.
Het patroon om te onthouden: je beleid staat in het ene systeem, je werkelijke gedrag in het andere, en niemand is eigenaar van de taak om die twee gelijk te houden.
De beslissing die niemand opschrijft
Onder het technische werk zit een beleidsvraag die meestal per ongeluk wordt beantwoord in plaats van bewust: welke geautomatiseerde bezoekers zijn welkom, en waarom.
Die vraag is lastiger dan hij lijkt, want twee verschillende activiteiten reizen onder één noemer. Crawlen om een model te trainen en crawlen om nú een antwoord samen te stellen voor iemand die naar jouw categorie vraagt, zijn twee dingen met twee soorten gevolgen. En ze zijn niet altijd uit elkaar te houden aan de user agent. Blokkeer je het eerste, dan blokkeer je soms ook het tweede. Voor een productcatalogus valt die ruil ongemakkelijk uit: de content die je beschermt, is productinformatie die je juist publiceert zodat mensen hem kunnen vinden.
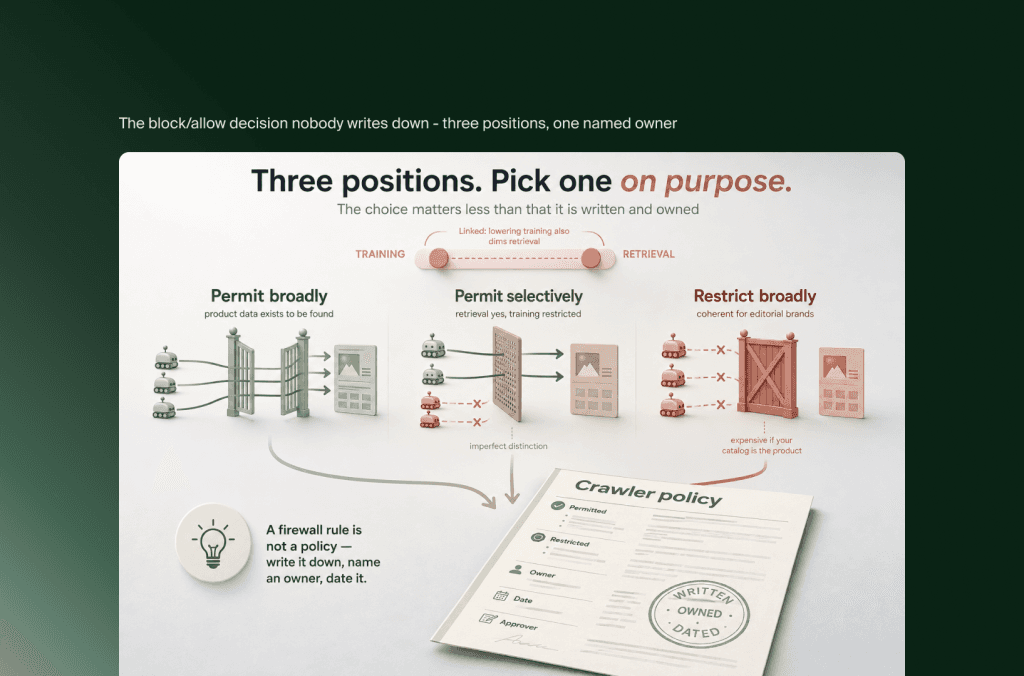
Drie posities zijn verdedigbaar, en een webshop hoort er bewust één van in te nemen.
Ruim toelaten, met als redenering dat productdata bestaat om gevonden te worden en dat staan in gegenereerde antwoorden meer waard is dan controle over hoe een model je catalogus heeft leren kennen. Selectief toelaten, waarbij je crawlers die antwoorden ophalen doorlaat en crawlers die vooral trainingsdata verzamelen tegenhoudt, in de wetenschap dat het onderscheid niet zuiver is en opnieuw langs moet zodra crawlerdocumentatie verandert. Of breed weren, wat een logische keuze is voor merken bij wie de redactionele content het product is, en een dure keuze voor een webshop bij wie de catalogus dat is.
Belangrijker dan de keuze is dat hij op papier staat, met een naam erbij van wie hem bewaakt. Een firewallregel die tijdens een incident is toegevoegd, is geen beleid. En die regel blijft langer bestaan dan de herinnering waarom hij er ooit kwam.
Wat je deze week kunt controleren
Vijf controles, geen ervan kost budget.
Haal je eigen pagina’s op als AI-crawler. Vraag een productpagina en een categoriepagina op terwijl je de user agents van de grote AI-crawlers meestuurt. Noteer de statuscode en of het antwoord je volledige HTML bevat. Een weigering of een lege body is je antwoord.
Leg je beleid naast het gedrag dat je meet. Lees je robots.txt en lees daarna je CDN- en WAF-regels. Noteer elke plek waar ze elkaar tegenspreken, want de infrastructuur wint.
Zoek naar rate limiting bij volume. Draai een crawl die groot genoeg is om iets te betekenen en let op reacties die pas halverwege opduiken in plaats van meteen. Een halve crawl levert een halve audit op, en zelfverzekerde conclusies die niet kloppen.
Kijk of je platform ondertekende crawlerverzoeken ondersteunt, en of de tools waarmee je audits draait ook echt ondertekenen. Dit is het verschil tussen je webshop auditen en het deel van je webshop auditen dat je firewall die dag wilde serveren.
Schrijf het beleid op. Eén pagina: welke crawlers mogen, welke niet, waarom, en wie wijzigingen goedkeurt. Zet er een datum bij.
Doe ze in deze volgorde. Bij verrassend veel webshops is de eerste controle meteen de laatste, omdat het antwoord er direct is en het werk terugvalt op één ticket voor de infrastructuur.
Verwachtingen bijgesteld
Publiceer llms.txt als je dat wilt, met de juiste verwachting erbij: het kost weinig, het kan agentic browsers en developer tooling helpen, en geen enkel groot AI-zoekproduct heeft toegezegd het te lezen. Zet het online, houd het kloppend en geef het geen plek in een plan voor zichtbaarheid. Sites met veel documentatie en API-producten hebben er meer aan dan welke catalogus ook.
Steek je aandacht liever in drie andere vragen. Krijgen AI-crawlers je pagina’s binnen? Doet je infrastructuur wat je beleid zegt? En heeft de vraag blokkeren-of-toelaten een eigenaar? Die drie bepalen of de rest van een AI-zoekprogramma überhaupt iets kan opleveren, en ze zijn saai genoeg om jarenlang onaangeroerd te blijven. In AI-consultancy is de toegangslaag de plek waar de eerste echte bevinding opduikt, ruim voordat er een contentvraag aan bod komt.
Veelgestelde vragen
Helpt llms.txt eCommerce-sites om in AI-zoekresultaten te verschijnen?
Daar is geen enkel gedocumenteerd bewijs voor. Google stelt dat er geen speciale machineleesbare bestanden nodig zijn voor zijn AI-functies, en onafhankelijk onderzoek naar adoptie op schaal vond geen effect op citaties, terwijl de meeste gepubliceerde bestanden nooit zijn opgehaald. De systemen die llms.txt vandaag aantoonbaar lezen zijn coding assistants en agent tooling, geen AI-zoekproducten voor consumenten.
Moet ik AI-crawlers blokkeren om mijn content te beschermen?
Dat is een beleidskeuze, geen technische keuze, en voor een productcatalogus valt de ruil scheef uit. Crawlers weren kan ook het ophalen van antwoorden blokkeren voor shoppers die naar jouw categorie vragen, omdat trainen en ophalen niet netjes te scheiden zijn op user agent. Wat je ook kiest: leg het vast als een besluit op papier met een eigenaar, in plaats van het aan een firewallregel over te laten.
Waarom zegt mijn robots.txt iets anders dan mijn logs laten zien?
Omdat robots.txt beleid uitspreekt en je CDN of web application firewall beslist of een verzoek wordt uitgeserveerd. Beveiligingslagen weigeren of vertragen geautomatiseerd verkeer regelmatig, los van wat robots.txt toestaat. Lees ze allebei en behandel het gedrag van de infrastructuur als het echte beleid, totdat je ze gelijk hebt getrokken.
Wat is Web Bot Auth en heb ik het nodig?
Het is een manier voor geautomatiseerde verzoeken om aan te tonen van welke agent ze komen, in plaats van beoordeeld te worden op een user-agentstring die iedereen kan claimen. Op platformen die het ondersteunen, worden ondertekende verzoeken anders behandeld dan niet-ondertekende. Dat telt voor crawlers die je webshop bereiken en voor je eigen audittools die een crawl willen afmaken.
Belangrijkste punten
llms.txt krijgt de meeste aandacht en heeft de minste gevolgen voor een productcatalogus. Google stelt dat er geen speciale bestanden nodig zijn voor zijn AI-functies, en grootschalig adoptieonderzoek liet zien dat het bestand zich gedraagt als ruis en niet als signaal voor citaties.
De laag met gevolgen is de infrastructuur. Een robots.txt die AI-crawlers toelaat, betekent niets als een CDN of firewall datzelfde verzoek weigert, en dat verschil is eerder regel dan uitzondering.
Blokkeren is beleid, geen techniek. Crawlen voor training en crawlen voor antwoorden zijn niet netjes te scheiden, dus wie het ene tegenhoudt, haalt een webshop soms weg uit antwoorden waar shoppers nú om vragen.
Vijf controles beantwoorden de vraag deze week, te beginnen met je eigen pagina’s ophalen als AI-crawler. Bij veel webshops is die eerste controle al genoeg en wordt het één ticket voor de infrastructuur.
De toegangslaag staat zelden op een contentkalender, want er komt geen oplevering uit die je kunt laten zien. Het is ook de enige laag waar één ongecontroleerde regel elke andere investering in AI-zichtbaarheid onleesbaar maakt.
Gerelateerde artikelen


