Ein Kunde fragte ChatGPT nach dem Besten in Ihrer Kategorie. Ihre Marke kam nicht vor.

Von Robin Laseur

Den Prompt abzusetzen dauert vier Sekunden. Zu verstehen, warum Ihr Name fehlte, dauert etwa eine Woche, und diese Woche ist deutlich mehr wert als die vier Sekunden. Das Fehlen in einer KI-Antwort hat fast nie eine einzige Ursache. Es ist der angesammelte Zustand eines Katalogs, einer Crawl-Historie und all dessen, was Dritte über Ihre Kategorie geschrieben haben. Dieser Zustand stand schon Monate fest, bevor jemand die Frage eintippte. Das Gute daran: Sie können das alles heute nachprüfen.
Was folgt, ist eine Rekonstruktion: ein zusammengesetztes Bild davon, wie eine solche Woche üblicherweise verläuft, aus dem Muster gebaut und nicht aus einer einzelnen Marke. Die Details sind illustrativ. Die Reihenfolge nicht.
Die vier Sekunden und die Woche danach
Marije verantwortet den E-Commerce einer Outdoor-Marke im Mittelsegment. An einem Dienstagnachmittag tippt sie ihre eigene Kategoriefrage in eine Chat-Oberfläche, vor allem aus Neugier, weil jemand im Führungskreis davon gesprochen hatte. Zurück kommen drei Produkte, jeweils mit einer kurzen Begründung, warum sie zum beschriebenen Einsatz passen. Keines davon ist ihres.
Der Reflex ist ein Content-Briefing. Jemand schlägt einen Kaufratgeber vor, jemand anders einen Beitrag über Materialien, und binnen zwanzig Minuten steht ein Plan für acht Artikel bis zum Quartalsende. Dieser Plan ist nicht falsch. Er ist die langsamste Reaktion auf eine Frage, die noch niemand untersucht hat, und er bindet ein Quartalsbudget an eine Vermutung.
Marije tut stattdessen etwas weniger Befriedigendes. Sie nutzt die Woche, um herauszufinden, was tatsächlich passiert ist.
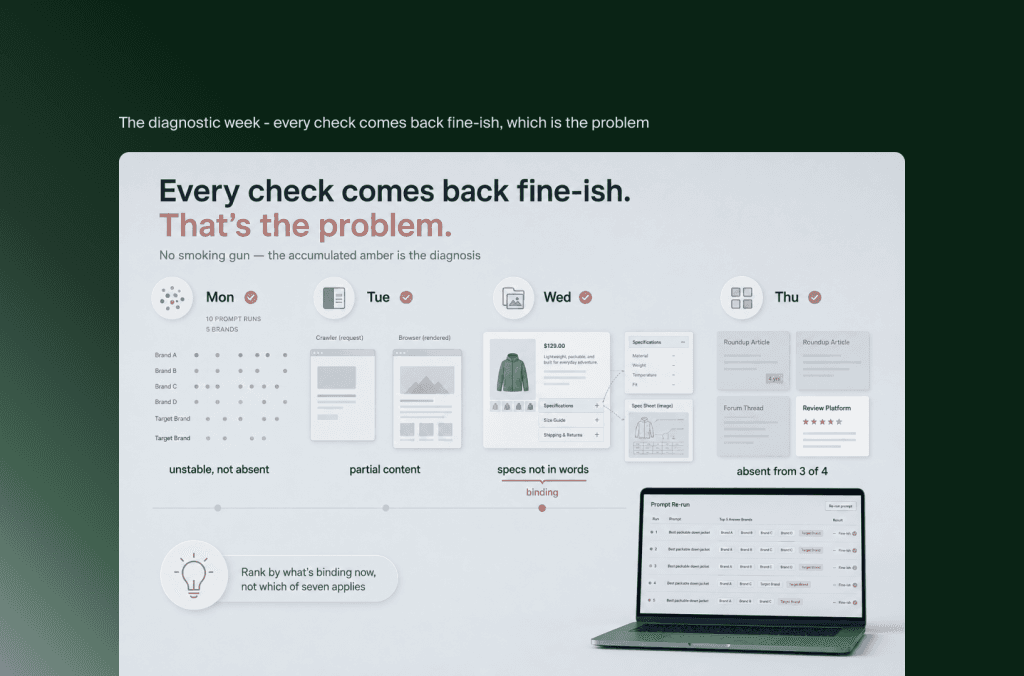
Alles ist in Ordnung, und genau das ist das Problem
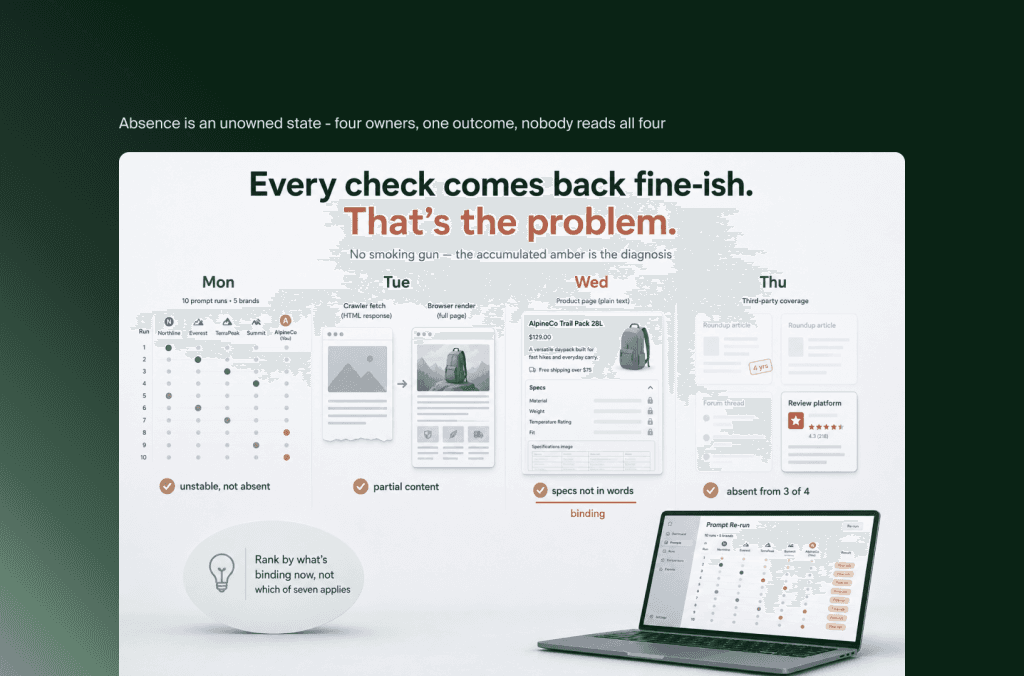
Tag eins lässt sie den Prompt noch neunmal laufen. Die Antworten variieren: über zehn Durchläufe tauchen fünf Namen auf, die Reihenfolge wechselt, und ihre Marke erscheint zweimal weit unten. Es geht also nicht um genannt oder nicht genannt. Es geht um geringe, schwankende Sichtbarkeit, und das ist ein anderes Problem mit anderen Ursachen, als unbekannt zu sein.
Tag zwei, die technische Prüfung. Die Website ist indexiert, die Rankings sind gesund, die Ladezeit ist ordentlich, die Sitemap ist sauber. Nichts davon erklärt irgendetwas, und die Versuchung, die Technik abzuhaken, ist groß. Sie bittet den Entwickler, eine Produktseite mit dem User Agent eines KI-Crawlers abzurufen statt mit dem eines Browsers. Zurück kommt nur ein Teil der Seite. Nicht blockiert, nicht kaputt, nur dünner als das, was ein Browser erhält, weil ein Teil der Seite erst nach dem Laden zusammengesetzt wird.
Tag drei, die Produktseiten. Liest sie eine davon als reinen Text, ohne Layout, findet sie den Preis und den Werbetext. Sie findet nicht die Materialzusammensetzung, das Gewicht, den Temperaturbereich oder den Hinweis zur Passform, denn die stecken in einem eingeklappten Tab und in einer Spezifikationsgrafik. Die Information ist vorhanden. Die Seite sagt sie nur nicht in Worten.
Tag vier, der Blick von außen. Sie liest die Quellen, aus denen ihre Wettbewerber gezogen wurden: zwei Übersichtsartikel von Verlagen, ein Thread in einem Fachforum und eine Bewertungsplattform. Auf der Bewertungsplattform ist ihre Marke vertreten, mit guten Noten. In den anderen drei fehlt sie, und einer der Übersichtsartikel ist vier Jahre alt.
Jede einzelne Prüfung lag irgendwo zwischen in Ordnung und leicht mangelhaft. Genau so fühlt sich diese Diagnose an, und deshalb sind die veröffentlichten Listen mit fünf oder sieben Ursachen in der Praxis schwer zu gebrauchen. In einem echten Shop trifft jede Ursache auf so einer Liste gleichzeitig ein Stück weit zu. Die Frage ist nicht, welche der sieben zutrifft. Die Frage ist, welche gerade den Ausschlag gibt.
Drei Weggabelungen
Am Freitag hat die Woche drei echte Entscheidungen hervorgebracht, keine To-do-Liste.
Gabelung eins: Rendering reparieren oder Content schreiben
Das Rendering-Problem kostet ein paar Entwicklertage und betrifft jede Seite im Katalog. Der Content-Plan kostet ein Quartal und betrifft nur die Seiten, die er abdeckt. Beides ist berechtigt; nur eines davon verändert, was jedes KI-System über jedes ihrer Produkte lesen kann. Die Reihenfolge ist die ganze Entscheidung, und die Antwort ist ungewöhnlich klar, sobald beides nebeneinanderliegt.
Gabelung zwei: Produkte beschreiben oder sie anpreisen
Die Spezifikationen, die in Tabs und Bildern stecken, sind kein neuer Content. Sie existieren bereits und müssen nur umziehen. Das ist eine Merchandising- und Template-Aufgabe, keine Schreibaufgabe, und sie beansprucht die Zeit anderer Leute als der Content-Plan. Deshalb kann sie parallel laufen statt danach.
Gabelung drei: Berichterstattung suchen oder abwarten
Übersichtsartikel bei Verlagen gehen langsam, hängen an Beziehungen und liegen außerhalb ihrer Kontrolle. Zugleich wiegen sie schwer in genau der Vergleichsfrage, mit der die Woche begann. Ehrlich betrachtet dauert das Quartale. Damit ist es nicht das, was man zuerst erledigt, sondern das, was man jetzt beginnt.
Keine dieser Gabelungen ist eine Taktik aus einer Liste. Jede ist eine Verteilung von Mitteln, mit einem Verantwortlichen und einer Reihenfolge. Das bringt eine Diagnose hervor, eine Kategorienliste nicht.
Was sie fand
Die Ursache, die den Ausschlag gab, war die zweite, und sie war langweilig.
Ihr Katalog beschrieb Produkte wunderbar im Fließtext und hielt sie fast nirgends in maschinenlesbarem Text fest. Systeme, die eine Frage wie „warm genug für das frühe Frühjahr, klein packbar, unter zweihundert Euro“ beantworten, gleichen mit Bedingungen ab, die ihre Seiten nie in Worten nannten. Der Marke wurde nicht misstraut, blockiert wurde sie auch nicht. Sie passte schlicht auf nichts.
Diese Erkenntnis kostete eine Woche und kein Budget. Die Abhilfe war eine Template-Änderung und ein Merchandising-Sprint über die zweihundert meistverkauften Produkte, kleiner als acht Artikel und früher fertig. Der Content-Plan blieb bestehen, verkleinert und nach hinten gerückt, ausgerichtet auf die Vergleichsfragen, die die Rekonstruktion zutage gefördert hatte, statt auf die Themen, die der Raum in den ersten zwanzig Minuten geraten hatte.
Sechs Wochen später brachten dieselben zehn Prompts ihre Marke in sechs Antworten statt in zwei. Das ist kein Triumph, und so hat sie es auch nicht berichtet, denn zehn Prompts sind eine kleine Stichprobe, und generierte Antworten bewegen sich von selbst. Es reicht, um weiterzumachen, und mehr trägt eine Stichprobe dieser Größe nicht.
Was sich verallgemeinern lässt
Drei Dinge, und über das erste lässt sich streiten.
Fehlen ist ein Symptom eines Zustands ohne Verantwortlichen, nicht einer vergessenen Taktik
Produktdaten liegen beim Merchandising, das Rendern der Seiten bei der Entwicklung, Erwähnungen bei Dritten beim Marketing, und der Crawler-Zugang bei demjenigen, der zuletzt die Firewall konfiguriert hat. Vier Verantwortliche, ein Ergebnis, und niemand, der alle vier überblickt. Marken erscheinen nicht deshalb nicht in Antworten, weil jemand eine Technik vergessen hat. Sie bleiben draußen, weil der Zustand, der diese Antworten entscheidet, sich an vier Stellen ansammelt, die niemand zusammen liest.
Die veröffentlichten Ursachenlisten stimmen und sind fast unbrauchbar
Klare Entitäten, strukturierte Daten, Autorität, Content-Struktur, Erwähnungen bei Dritten, Aktualität: alles real, alles in jedem Shop ein Stück weit zutreffend. Eine Liste aller möglichen Fehler ist keine Diagnose. Diese Ursachen nach den eigenen Belegen zu ordnen, das ist eine.
Hinschauen ist billig und kommt zuerst
Eine Woche schauen kostet einen Bruchteil eines Quartals Publizieren und fördert regelmäßig etwas Gewöhnliches zutage, das schnell zu beheben ist. In der KI-Beratung kommt der erste echte Befund meist in den ersten drei Tagen, und es ist fast nie das, was der Raum in dem Moment vorhergesagt hat, als die Frage aufkam.
Die vier Sekunden fühlten sich wie ein Urteil an. Sie waren eher ein Symptom, und ein Symptom untersucht man erst und behandelt es danach.
Häufig gestellte Fragen
Warum erscheint meine Marke in manchen KI-Antworten und in anderen nicht?
Generierte Antworten unterscheiden sich nach Formulierung, Plattform, Personalisierung und den Quellen, die im Moment der Generierung verfügbar sind. Einen Prompt einmal laufen zu lassen sagt fast nichts. Denselben Satz Prompts mehrmals auf zwei Plattformen laufen zu lassen zeigt, ob Sie stabil präsent sind, schwankend präsent oder wirklich abwesend. Diese drei Lagen haben unterschiedliche Ursachen.
Wird meine Marke von KI-Systemen blockiert?
Gelegentlich, und prüfen Sie es früh, denn der Test ist billig und er entwertet alles andere. Rufen Sie Ihre eigenen Seiten mit den User Agents von KI-Crawlern ab und vergleichen Sie die Antwort mit dem, was ein Browser erhält. Eine halbe Seite kommt häufiger vor als eine klare Ablehnung, und sie führt zum selben Ergebnis, nur leiser.
Soll ich mehr Content veröffentlichen, um das zu lösen?
Vielleicht, aber nicht zuerst. Content ist die langsamste und teuerste Reaktion, die es gibt, und sie zielt häufig auf Themen, die geraten statt untersucht wurden. Nehmen Sie sich eine Woche, um Rendering, die Vollständigkeit Ihrer Produktdaten und die tatsächlich genutzten Fremdquellen zu prüfen. Entscheiden Sie danach, was Sie veröffentlichen, mit diesen Belegen auf dem Tisch.
Das Wichtigste in Kürze
Das Fehlen in KI-Antworten ist angesammelter Zustand, keine vergessene Technik. Katalogdaten, das Rendern der Seiten, der Crawler-Zugang und Erwähnungen bei Dritten trugen alle bei, und alles stand fest, bevor die Frage gestellt wurde.
Unterscheiden Sie Abwesenheit von schwankender Sichtbarkeit. Zehn Durchläufe desselben Prompts auf zwei Plattformen trennen eine Marke, die niemand kennt, von einer Marke, die mal auftaucht und mal nicht, und beide brauchen andere Arbeit.
Die veröffentlichten Ursachenlisten stimmen und sind schwer umzusetzen, denn in einem echten Shop trifft jede Ursache ein Stück weit zu. Ordnen Sie sie nach Ihren eigenen Belegen, statt die Liste von oben nach unten abzuarbeiten.
Erst prüfen, dann veröffentlichen. Eine Woche Hinschauen ist ein Bruchteil eines Quartals Content-Produktion und fördert meist etwas Gewöhnliches auf Template-Ebene zutage, das schnell zu beheben ist.
Das Unangenehme an dieser Diagnose ist zugleich das Ermutigende. Die Antwort, in der Sie fehlten, war kein Urteil über Ihre Marke. Sie war eine Wiedergabe dessen, was Ihre Systeme über Ihre Produkte sagten, zusammengesetzt von etwas, das nur mit dem arbeiten konnte, was es vorfand.
Verwandte Artikel


