Mehr Tests bedeuten nicht mehr Umsatz: Shopify-CRO-Experimente priorisieren

Von Robin Laseur

Shopify-CRO-Experimente priorisieren, ein Beispiel aus der Praxis. Ein CRO-Team präsentiert sein Quartal. Die erste Zahl auf der Folie ist das Tempo: vierzig Experimente live, nach fünfundzwanzig im Quartal davor. Die Folie strahlt Schwung aus. Dann stellt jemand die einzige Frage, die zählt: Was hat der Umsatz gemacht? Es wird still im Raum, denn die ehrliche Antwort lautet: so gut wie nichts. Die Tests liefen. Der Umsatz blieb, wo er war.
Das ist der häufigste Fehler in der E-Commerce-CRO, und im Kern ist es ein Rechenfehler. Mehr Tests bedeuten nicht mehr Umsatz. Ab einer Grenze, die Ihr Traffic setzt, bedeuten mehr Tests sogar weniger Umsatz. Was ein Testprogramm über die Zeit wachsen lässt, ist nicht die Zahl der Experimente, sondern die Auswahl derer, die Sie bewusst nicht durchführen. Um diese Disziplin geht es hier: warum Tempo irgendwann nichts mehr bringt und wie Sie einen Backlog so ordnen, dass die Tests, die live gehen, die wenigen sind, die tatsächlich Geld bewegen.
Warum mehr Tests nicht mehr Umsatz bringen
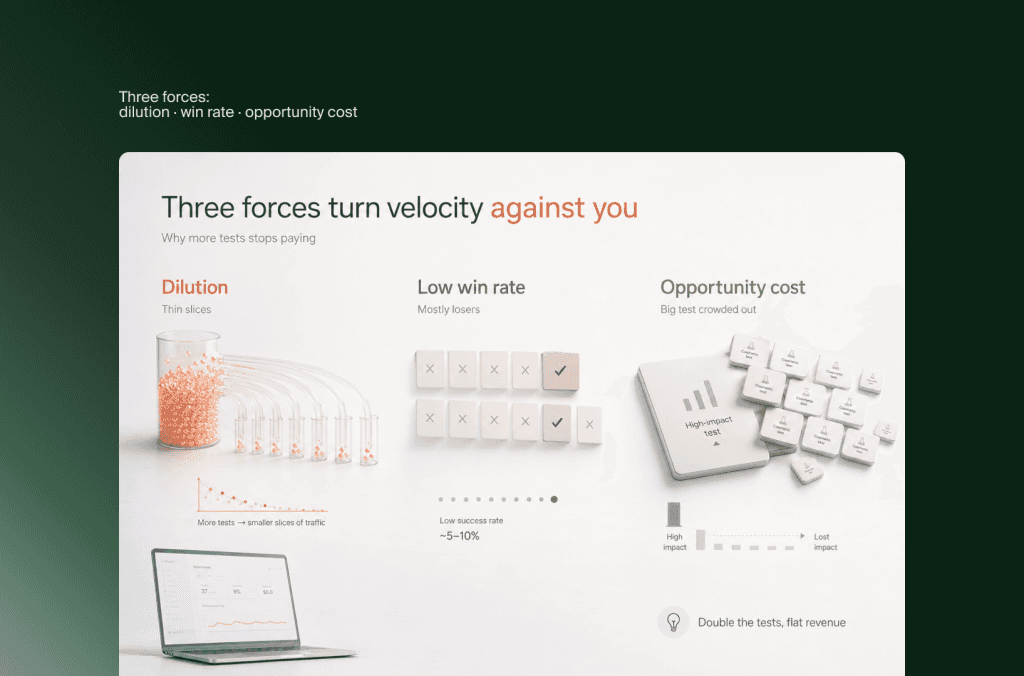
Mehr Tests bringen nicht mehr Umsatz, weil der Wert von Tests sehr ungleich verteilt ist und die statistische Teststärke begrenzt ist. Wenige Tests mit großer Wirkung liefern fast den gesamten Gewinn. Die meisten Tests gewinnen überhaupt nicht. Und jeder zusätzliche Test konkurriert um denselben knappen Traffic, den jeder Test braucht, um Signifikanz zu erreichen. Ab einer Grenze, die Ihr Traffic setzt, senkt jeder weitere Test die Rendite des Programms, statt sie zu steigern.
Drei Kräfte wenden das Tempo gegen Sie, und der Rest dieses Beitrags nimmt sie sich nacheinander vor. Die erste ist Verdünnung. Ein Shop hat nur eine bestimmte Zahl an Sessions und Conversions, und mit ihnen bezahlen Sie statistische Signifikanz. Laufen mehr Tests gleichzeitig, bekommt jeder ein dünneres Stück, und weniger erreichen ein belastbares Ergebnis. Die zweite ist die Erfolgsquote, die Win Rate. Die meisten Tests gewinnen schlicht nicht. Mehr schwache Experimente erzeugen vor allem mehr Verlierer und, schlimmer noch, mehr falsch-positive Ergebnisse, die Sie für Gewinner halten. Die dritte sind die Opportunitätskosten. Weil die Wirkung in einer Handvoll Änderungen steckt, die wirklich etwas verschieben, verdrängt ein Backlog voller kleiner kosmetischer Tests die wenigen großen, auf die es angekommen wäre.
Zusammen erklären sie, warum ein Team die Zahl seiner Tests verdoppeln kann, während der Umsatz flach bleibt. Tempo fühlt sich nach Fortschritt an, weil es sich leicht zählen lässt, und genau das macht es zur Vanity Metric. Das Programm, das wächst, ist nicht das mit den meisten Experimenten. Es ist das Programm, das seinen knappen Traffic in möglichst wenige Tests mit dem höchsten Erwartungswert steckt und die Disziplin hat, den Rest liegen zu lassen. Die nächsten drei Abschnitte zeigen, warum das so ist. Der letzte zeigt, wie Sie auswählen.
Knapp ist der Traffic, nicht die Ideen
Fast jedes Shopify-CRO-Programm scheitert nicht an fehlenden Testideen. Es scheitert an fehlendem Traffic und fehlenden Conversions, um einen echten Gewinner von Rauschen zu unterscheiden. Statistische Signifikanz gibt es nicht umsonst. Sie bezahlen sie mit Sessions, und die meisten Shops haben davon weniger, als ihr Test-Backlog voraussetzt.
Die Rechnung ist gnadenlos, und es lohnt sich, sie zu verinnerlichen. Ein belastbarer A/B-Test braucht in der Regel rund tausend Conversions oder mehr pro Variante, gesammelt über mindestens ein paar Wochen, bevor das Ergebnis etwas aussagt. Deshalb lehnen seriöse Testagenturen Experimente auf Shops mit weniger als etwa fünfzigtausend Sessions im Monat oft ab. Darunter dauert ein Test Monate oder erreicht nie Signifikanz. Lassen Sie auf einem kleineren Shop mehrere Tests gleichzeitig laufen, haben Sie Ihren Erkenntnisgewinn nicht vervielfacht. Sie haben Ihren ohnehin knappen Traffic auf Experimente verteilt, die nun jeweils noch länger dauern oder ohne Ergebnis enden. Das ist das teuerste Ergebnis überhaupt: Es verbraucht Traffic und liefert nichts.
Wer das ignoriert, bekommt einen Backlog, der produktiv aussieht und Rauschen produziert. Ein schwacher Test auf einem Shop mit wenig Traffic kostet Wochen des Wartens auf ein Ergebnis, das statistisch wackelig und kommerziell belanglos ist. Das Team will eine Antwort, bricht zu früh ab oder liest ein Muster in den Zufall. Hier sitzt der Fluch des Gewinners: Stoppen Sie einen Test, sobald er kurz im Plus liegt, verbuchen Sie einen „Gewinn“, der Glück war. Sie setzen ihn um und wundern sich später, warum der Gesamtumsatz nie die Summe Ihrer Siege widerspiegelt.
Der erste Schritt beim Priorisieren ist also nicht, Ideen zu bewerten, sondern ehrlich auf Ihr Traffic-Budget zu schauen. Schätzen Sie, wie viele Tests Ihr Shop in einem Quartal tatsächlich bis zur Signifikanz bringen kann. Für die meisten Shopify-Shops ist diese Zahl klein: oft eine Handvoll, nicht Dutzende. Diese eine Grenze stellt alles Weitere in ein neues Licht. Können Sie nur wenige Tests wirklich durchführen, geht es nur noch darum, die richtigen zu wählen. Bleibt die Frage, was einen Test einen dieser knappen Plätze wert macht. Die Antwort beginnt damit, wie selten Tests überhaupt gewinnen.
Die meisten Tests verlieren, also entscheidet die Hypothese
Die meisten A/B-Tests gewinnen nicht. Branchenweit liegt der Anteil der Experimente, die eine statistisch signifikante Verbesserung einer echten kommerziellen Kennzahl bringen, irgendwo zwischen einem Fünftel und einem Drittel. Bei strengerer Definition ist es eher einer von zehn. Diese Basisrate ist die aufschlussreichste Tatsache in der CRO. Sie bedeutet: Nicht das Testen an sich trennt ein Programm, das wächst, von einem, das sich im Kreis dreht, sondern die Qualität der Hypothese hinter dem Test.
Wer die Basisrate akzeptiert, sieht den Mechanismus sofort. Wenn nur eine Minderheit der Tests gewinnt, bleiben Sie mit mehr Tests ohne bessere Auswahl bei derselben niedrigen Erfolgsquote, nur mit mehr Volumen. Sie erzeugen mehr Verlierer und verbrauchen dafür mehr Traffic. Der Hebel ist nicht das Volumen, sondern eine höhere Erfolgsquote, und die hängt an Belegen. Ein Test, der auf einem echten, beobachteten Problem aufbaut, hat eine weit bessere Chance als einer, der auf einer Meinung aus dem Besprechungsraum über einen Button beruht. Denken Sie an einen Checkout-Schritt, bei dem Session-Recordings Zögern zeigen, an eine Exit-Umfrage, in der Käufer einen konkreten Zweifel nennen, oder an eine Seite, auf der die Analytics einen deutlichen Einbruch zeigen. Teams mit ungewöhnlich hoher Erfolgsquote testen fast nie mehr. Sie testen Hypothesen, die auf quantitativen und qualitativen Daten beruhen. Deshalb kann dieselbe Änderung, die als Vermutung scheitert, als belegte Wette gewinnen.
Die Basisrate zu missachten ist teuer, und die Kosten wachsen unbemerkt. Kosmetische Tests, etwa ein Button in neuer Farbe oder umformulierte Microcopy ohne Begründung, schneiden im Schnitt schlecht ab. Trotzdem dominieren sie die meisten Backlogs, weil sie leicht auszudenken und leicht umzusetzen sind. Jeder davon verbraucht einen Teil Ihres knappen Traffics, um eine Hypothese zu prüfen, die das Verhalten wahrscheinlich nie verändert hätte. Die stärksten E-Commerce-Tests verändern, wie sich Kunden fühlen, wie sie entscheiden oder wie sie ein Produkt finden, nicht nur, wie etwas aussieht. Der Unterschied liegt in den Belegen, nicht im Aufwand.
Was zu tun ist, ergibt sich daraus direkt. Bevor ein Test einen Platz bekommt, muss er eine Beweishürde nehmen: Welche konkreten Daten zeigen, dass das ein echtes Problem ist, und warum sollte die geplante Änderung es plausibel lösen? Eine Hypothese, die nicht beides beantworten kann, ist nicht reif für einen Test. Sie trotzdem laufen zu lassen, ist genau der Weg, auf dem ein Programm beschäftigt bleibt und die Erfolgsquote niedrig. Dieselbe Disziplin steht im Zentrum der strukturierten CRO-Zyklen, die dauerhaft erfolgreiche Programme von einer Reihe einzelner Experimente unterscheiden.
Der echte Hebel sind die Tests, die Sie nicht durchführen
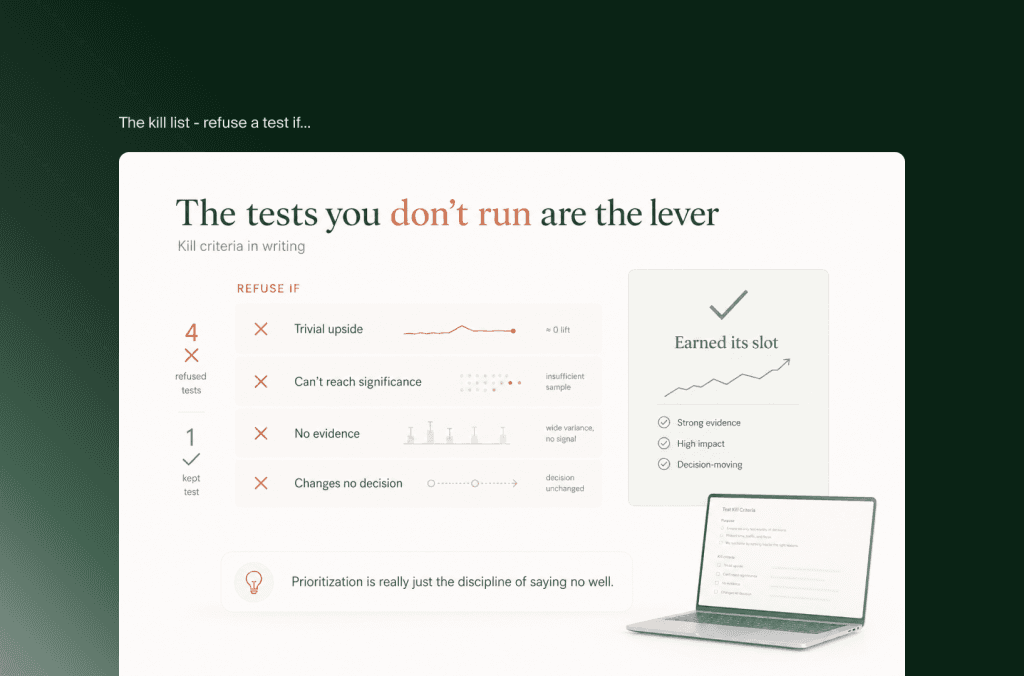
Hier kommt die Wendung, auf die dieser ganze Beitrag hinausläuft. Weil Traffic begrenzt ist und die meisten Tests verlieren, ist die wichtigste Entscheidung in einem CRO-Programm nicht, welche Tests Sie durchführen. Es ist die Entscheidung, welche Sie ablehnen. Ein Backlog ist keine To-do-Liste zum Abarbeiten. Er ist eine Sammlung konkurrierender Ansprüche auf eine knappe Ressource, und jeder Test, zu dem Sie Ja sagen, ist Traffic, den Sie allen anderen Tests verweigern. Priorisieren ist im Grunde die Disziplin, gut Nein zu sagen.
Der Mechanismus sind Opportunitätskosten, verschärft durch die ungleiche Verteilung der Wirkung. Wenn wenige Änderungen den Großteil des möglichen Gewinns liefern, kostet ein Test mit geringer Wirkung mehr als nur sein eigenes schwaches Ergebnis. Er kostet auch den Test mit großer Wirkung, der dieselben Wochen Traffic hätte nutzen können und nicht zum Zug kam, weil ein kosmetisches Experiment den Platz belegte. Kann ein Shop nur eine Handvoll Tests pro Quartal stemmen, halbieren schon ein oder zwei belanglose Tests auf diesen Plätzen den tatsächlichen Ertrag des Programms für diesen Zeitraum. Auf einem Dashboard, das Tempo misst, ist diese Verschwendung unsichtbar. Dort zählt der belanglose Test als Fortschritt, nicht als der verpasste Gewinn, der er in Wahrheit ist.
Deshalb zählt eine Streichliste mehr als eine Wunschliste. Die Tests, die Sie sofort ablehnen sollten, fallen in vier erkennbare Gruppen. Tests, deren größtmöglicher Nutzen selbst bei einem Gewinn kommerziell belanglos ist. Tests, die mit Ihrem Traffic in keinem vernünftigen Zeitraum Signifikanz erreichen. Tests, hinter denen kein anderer Beleg steht als eine Vorliebe. Und Tests, deren Ergebnis keine einzige Entscheidung ändern würde, egal wie es ausfällt. Ein Test, der an einem dieser Punkte scheitert, ist keine niedrigere Priorität für später. Er ist ein Nein, und das auszusprechen schützt den Traffic, von dem Ihre wenigen echten Wetten abhängen. Unbequem ist der kulturelle Teil: Das Lieblingsprojekt eines Stakeholders zu streichen ist schwerer, als es still in den Backlog aufzunehmen. Genau deshalb testen schwache Programme alles und starke nicht.
Machen Sie das Ablehnen also ausdrücklich und einfach. Halten Sie die Ausschlusskriterien schriftlich fest, damit ein Nein eine Regel ist und kein persönliches Urteil. Und bleiben Sie dabei, dass ein nicht durchgeführter Test kein Mangel an Ehrgeiz ist, sondern eine bewusste Entscheidung, knappen Traffic dort einzusetzen, wo er sich auszahlt. Die Programme, die sich absetzen, sind beim Testen nicht mutiger. Sie kommen besser damit klar, nicht zu testen, und genau diese Gelassenheit ist indirekt die Quelle ihrer Ergebnisse.
Genau diese Disziplin, weniger Tests mit besseren Belegen, bringt eine spezialisierte Shopify-Plus-Agentur in einen CRO-Retainer ein, statt dem Tempo um seiner selbst willen hinterherzulaufen.
So bringen Sie Ihre Tests in die richtige Reihenfolge
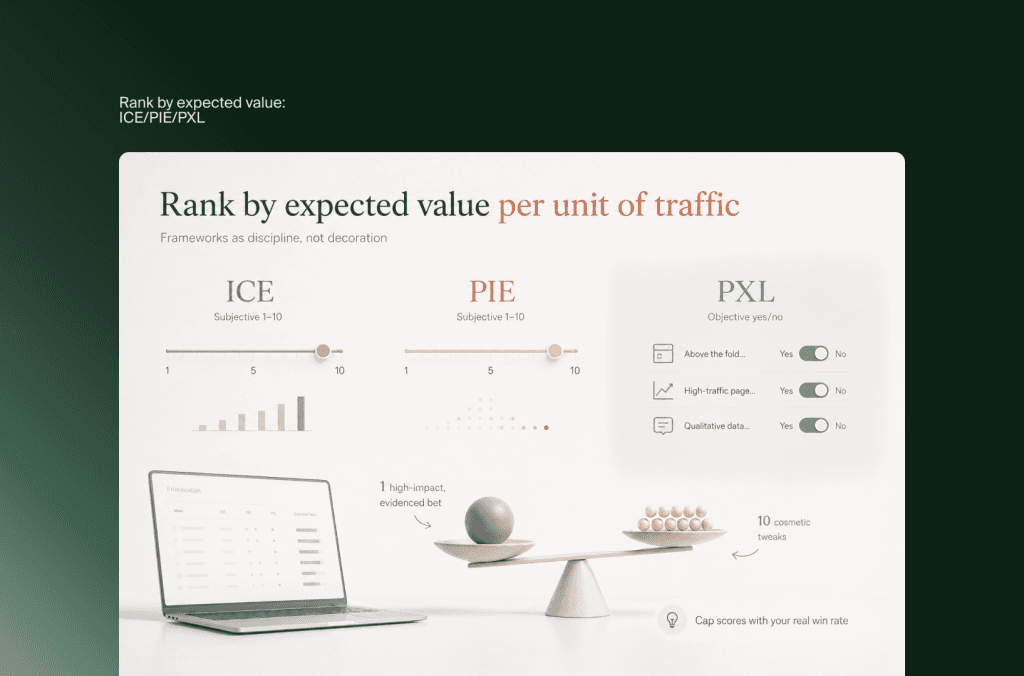
Wenn das Traffic-Budget feststeht und die Ausschlusskriterien vorliegen, ist die Rangfolge des Rests der einfache Teil. Sie folgt einer Idee: Ordnen Sie nach Erwartungswert pro Einheit Traffic, nicht danach, wie reizvoll eine Idee wirkt. Der Erwartungswert ist hier das ehrliche Produkt aus drei Dingen: wie groß der Gewinn ist, wenn der Test gewinnt, wie wahrscheinlich er tatsächlich gewinnt und wie viel der Traffic wert ist, den er berührt. Das teilen Sie durch den Traffic und die Zeit, die der Test bis zum Ergebnis verbraucht. Ein Test mit großem möglichem Uplift auf Ihrer umsatzstärksten Seite, gestützt durch echte Belege, ist mehr wert als zehn kosmetische Anpassungen auf einer Seite, auf der niemand kauft.
Die etablierten Scoring-Modelle sind nützlich, solange Sie sie als Disziplin nutzen und nicht als Dekoration. ICE (Impact, Confidence, Ease) und PIE (Potential, Importance, Ease) sind gute Ausgangspunkte. Ihre Schwäche: Die Scores sind subjektiv, und Optimismus treibt sie hoch, bis alles eine Neun ist. PXL, das Modell des CXL-Teams, behebt das, indem es vage Skalen von eins bis zehn durch objektive Ja/Nein-Fragen ersetzt: Liegt die Änderung above the fold, sitzt sie auf einer Seite mit viel Traffic, gibt es qualitative Daten, die sie stützen? Der Wert dieser Modelle liegt nicht in der Zahl, die herauskommt. Er liegt darin, dass sie für jeden Test dieselben ehrlichen Eingaben erzwingen: Belege, Aufwand und wo das Geld liegt. So wird der Vergleich fair.
Kriterium | Die Frage dahinter | Warum es die Priorität bestimmt |
Wo das Geld liegt | Betrifft das eine Seite mit viel Traffic, viel Umsatz oder vielen Abbrüchen? | Ein Gewinn auf einer Seite, die niemand besucht, ändert nichts. Die Wirkung wächst mit dem Traffic und dem Umsatz hinter der Seite |
Stärke der Belege | Welche quantitativen und qualitativen Daten zeigen, dass das ein echtes Problem ist? | Belege heben die Erfolgsquote über die magere Basisrate. Eine Vorliebe ist kein Beleg |
Größe des Gewinns | Lohnt sich der Nutzen kommerziell, wenn der Test gewinnt? | Ein statistisch echter, aber belangloser Uplift ist ein Platz, verschwendet an einen Rundungsfehler |
Machbarkeit | Erreicht dieser Test mit unserem Traffic in vernünftiger Zeit Signifikanz? | Ein Test ohne Ergebnis ist Traffic, ausgegeben für keine Antwort |
Es gibt eine ehrliche Eingabe, auf die sich die Modelle stützen und die die meisten Teams schätzen statt messen: Ihre eigenen Zahlen. Nehmen Sie sich vor Ihrem nächsten Priorisierungs-Meeting die Ergebnisse Ihrer letzten zwanzig Tests vor und berechnen Sie Ihre echte Erfolgsquote und Ihren Median-Uplift. Diese Werte fallen bei den meisten Shops bescheidener aus als erwartet. Sie werden zur Obergrenze für jeden künftigen Impact-Score, nehmen den Optimismus aus der Übung und verankern sie in dem, was Ihr Programm tatsächlich leistet. Verlässliche Benchmarks zu Win Rate und Konfidenz helfen beim Abgleich mit Ihren eigenen Werten. Priorisieren ist kein Tabellenritual. Es ist die feste Entscheidung, knappen Traffic nur dort einzusetzen, wo der erwartete Ertrag es rechtfertigt, und diese Entscheidung immer wieder an Ihren eigenen Ergebnissen zu prüfen.
Häufig gestellte Fragen
Wie viele A/B-Tests sollte ich auf Shopify gleichzeitig laufen lassen? Weniger, als Sie denken, und die Zahl bestimmt Ihr Traffic, nicht Ihr Ehrgeiz. Weil Signifikanz rund tausend Conversions oder mehr pro Variante verlangt, können die meisten Shopify-Shops nur eine Handvoll belastbarer Tests pro Quartal stemmen. Laufen mehr gleichzeitig, teilen Sie Ihren Traffic auf, und jedem Test fehlt die nötige Teststärke. Ein gut gewählter Test mit klarem Ergebnis ist meist besser als drei mit unklarem.
Welches Priorisierungsmodell ist das beste: ICE, PIE oder PXL? Das Modell ist weniger wichtig als die Ehrlichkeit der Eingaben. ICE und PIE sind schnell, aber ihre subjektiven Scores fallen zu optimistisch aus. PXL verringert diese Verzerrung mit objektiven Ja/Nein-Fragen und ist für ein ernsthaftes Programm die bessere Wahl. Egal, welches Sie nutzen: Seine eigentliche Aufgabe ist, jedem Test dieselben Fragen zu Belegen und Wirkung zu stellen und als Ausschlussfilter zu dienen, nicht nur als Rangliste.
Habe ich genug Traffic für A/B-Tests in meinem Shopify-Shop? Als Faustregel braucht aussagekräftiges A/B-Testing genug Conversions, um innerhalb weniger Wochen rund tausend pro Variante zu erreichen. Viele Shops schaffen das ab etwa fünfzigtausend Sessions im Monat. Darunter dauern Tests zu lang oder enden ohne Ergebnis. Shops mit weniger Traffic fahren meist besser, wenn sie belegte Änderungen direkt umsetzen und nur die Änderungen mit der größten Wirkung testen, bei denen sich ein großer Effekt auch mit kleineren Stichproben nachweisen lässt.
Was ist eine gute Win Rate bei CRO? Branchenweit liegt die Quote statistisch signifikanter, kommerziell relevanter Ergebnisse meist zwischen etwa einem von zehn und einem von drei Tests, je nachdem, wie streng Sie einen Gewinn definieren. Eine höhere Erfolgsquote spiegelt meist bessere Hypothesen und stärkere Belege wider, nicht mehr Tests. Verfolgen Sie Ihre eigene Erfolgsquote und Ihren Median-Uplift über die Zeit. Das ist der ehrlichste Maßstab dafür, ob Ihre Priorisierung besser wird.
Das Wichtigste in Kürze
Tempo ist eine Vanity Metric. Mehr Tests bedeuten nicht mehr Umsatz. Ab einer Grenze, die Ihr Traffic setzt, bedeuten sie sogar weniger, weil der Wert von Tests sehr ungleich verteilt und die Teststärke begrenzt ist.
Knapp ist der Traffic, nicht die Ideen. Signifikanz kostet Sessions, deshalb können die meisten Shopify-Shops nur eine Handvoll belastbarer Tests pro Quartal stemmen. Kennen Sie dieses Budget, bevor Sie irgendetwas ordnen.
Die Hypothese entscheidet. Die meisten Tests verlieren. Die Gewinner stützen sich auf quantitative und qualitative Belege, nicht auf Meinungen aus dem Besprechungsraum. Lassen Sie jeden Test eine Beweishürde nehmen.
Der Hebel sind die Tests, die Sie nicht durchführen. Priorisieren ist die Disziplin, Nein zu sagen. Halten Sie Ausschlusskriterien schriftlich fest, damit das Ablehnen eines schwachen Tests Regel ist und keine Politik.
Ordnen Sie nach Erwartungswert pro Einheit Traffic. Nutzen Sie ICE, PIE oder PXL, um ehrliche Eingaben zu erzwingen, und deckeln Sie Ihre Impact-Scores mit Ihrer eigenen Erfolgsquote und Ihrem Median-Uplift.
Verwandte Artikel


