SEO-Audit für Shopify mit Screaming Frog: So finden Sie technische Probleme

Von Robin Laseur

Ein Shopify-Shop kann nach außen stabil wirken und trotzdem strukturelle Probleme haben, die das organische Wachstum bremsen. Die Navigation funktioniert, Seiten laden, Produkte sind erreichbar. Dahinter bleiben doppelte URLs, schwache interne Verlinkung und Unstimmigkeiten bei der Indexierung aber oft unbemerkt.
Wenn Sie einen Shopify-Shop mit Screaming Frog crawlen, geht es nicht darum, URLs zu sammeln. Es geht darum zu verstehen, wie Suchmaschinen Ihre Website tatsächlich sehen und wo dieses Bild Risse bekommt. Ohne die richtige Einrichtung liefern Crawls oft unvollständige oder irreführende Daten. Dann können Sie dem Ergebnis kaum trauen, geschweige denn die richtigen Fixes priorisieren.
Eine solide technische SEO-Basis zählt nicht nur für klassische Rankings. Immer mehr Käufer entdecken und vergleichen Produkte über KI-generierte Antworten. Wie gut sich ein Shopify-Shop crawlen lässt und wie er aufgebaut ist, entscheidet dann direkt darüber, ob er in diesen Antworten auftaucht. Eine saubere Shop-Architektur und korrekte Indexierung sind also nicht mehr nur eine Anforderung von Google. Sie werden auch zur Grundlage für Sichtbarkeit in generativen Suchmaschinen.
In diesem Artikel erfahren Sie:
Wie Sie einen Shopify-Shop mit Screaming Frog crawlen, ohne auf unvollständigen Daten sitzen zu bleiben
Warum Shopify-Shops oft uneinheitliche Crawl-Ergebnisse liefern
Welche Einstellungen direkt über die Genauigkeit des Crawls entscheiden
Wie Sie aus Crawl-Daten SEO-Verbesserungen machen, die Ihr Wachstum tatsächlich voranbringen
Ein guter Crawl findet nicht nur Fehler. Er zeigt Ihnen, was Ihren Shop bremst und wo Sie zuerst ansetzen sollten.
Warum die meisten Shopify-Shops versteckte technische SEO-Probleme haben
Mit Shopify sind Sie schnell live. Ein gründliches Audit ist eine ganz andere Aufgabe.
Die Plattform kümmert sich um Hosting, Sicherheit und Checkout. Was sie nicht übernimmt: dafür zu sorgen, dass URL-Struktur, interne Verlinkung und Metadaten mithalten, wenn das Sortiment wächst. Produktvarianten erzeugen doppelte URL-Pfade. Kollektionsfilter erzeugen indexierbare Parameter-URLs. Blogartikel häufen sich an, ohne klare Verlinkungsstrategie. Nichts davon sehen Sie im Frontend des Shops.
Shopify selbst schreibt, dass Website-Crawler dieselben HTML-Inhalte und Linkbeziehungen auslesen, anhand derer Suchmaschinen über das Ranking von Seiten entscheiden. Damit gehören Crawler zu den direktesten Wegen, um zu sehen, was Google tatsächlich sieht, und nicht, was ein Besucher sieht. Diese beiden Sichten unterscheiden sich oft deutlich.
Ohne Crawl beruhen SEO-Entscheidungen auf Annahmen. Mit Crawl wird sichtbar, wie der Shop tatsächlich aufgebaut ist.
Was Screaming Frog zeigt, wenn Sie einen Shopify-Shop crawlen
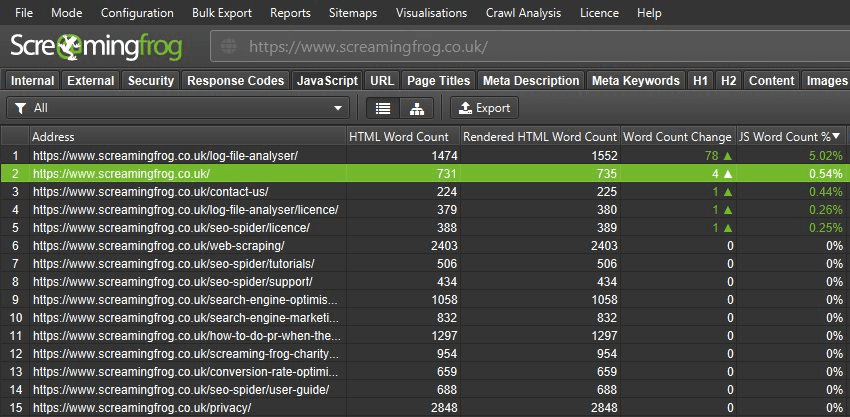
Screaming Frog SEO Spider ist ein Desktop-Crawler, der Ihren Shop auf URL-Ebene durchgeht und von jeder gefundenen Seite die technischen Daten ausliest. Bei Shopify-Shops kommt dabei Folgendes ans Licht:
HTTP-Statuscodes, Serverfehler und Weiterleitungsketten
Title-Tags, Meta-Descriptions und Überschriftenstruktur
Canonical-Tags und Noindex-Anweisungen
Anzahl interner Links und Crawl-Tiefe
Strukturierte Daten und Schema-Validierung
Wortanzahl und inhaltliche Signale auf Seitenebene
Ein Crawl zeigt nicht, was falsch ist. Er zeigt, wo Sie genauer hinsehen sollten. Ihren eigentlichen Wert bekommen die Crawl-Daten erst, wenn Sie sie mit Leistungskennzahlen verknüpfen: Welche Seiten bringen Traffic, welche bringen Umsatz, und welche stehen im Index, ohne etwas beizutragen?
Ohne diesen kommerziellen Kontext beheben Sie zuerst die falschen Dinge.
Screaming Frog für Shopify einrichten: Die Konfiguration bestimmt die Crawl-Qualität
Die meisten unvollständigen Shopify-Crawls liegen nicht am Shop selbst. Sie liegen an Entscheidungen, die vor dem Start des Crawls fallen. Diese vier Schritte bestimmen, wie verlässlich alles Weitere ist.
Database Storage Mode aktivieren
Standardmäßig speichert Screaming Frog Crawl-Daten im Arbeitsspeicher. Bei großen Shopify-Katalogen mit Tausenden Produkt-, Kollektions- und Blogseiten wird der Rechner dadurch deutlich langsamer, und mitten im Crawl drohen Daten verloren zu gehen.
Im Database Storage Mode landen die Crawl-Daten stattdessen auf der Festplatte. Das stabilisiert den Prozess, Sie können Crawls speichern und über die Zeit vergleichen, und Sie sehen leichter, wie sich der Shop nach technischen Fixes oder neuen Inhalten verändert. Für laufende SEO-Arbeit an Shopify ist diese Einstellung keine Option, sondern die Grundlage für ein wiederholbares Audit.
Die Web-Bot-Auth-Signatur von Shopify einrichten
Das ist der wichtigste Konfigurationsschritt für jeden Shopify-Crawl. Im August 2025 hat Shopify Web Bot Auth eingeführt. Damit erzeugen Sie für Ihren Shop kryptografisch gesicherte HTTP-Signaturen und autorisieren so Ihre eigenen Crawler.
Ohne gültige Signatur stuft die Sicherheitsebene von Shopify, die auf Cloudflare basiert, Anfragen von Crawlern als verdächtigen automatisierten Traffic ein. Laut der Dokumentation von Screaming Frog entstehen genau so die Fehler 429 Too Many Requests, die große Shopify-Audits unterbrechen. Der Crawl bleibt hängen, die Daten sind unvollständig, und auf die Ergebnisse ist kein Verlass.
Mit Signatur erkennt Shopify die Anfragen als autorisiert. Der Crawl läuft ohne Unterbrechung von Anfang bis Ende durch.
So richten Sie eine Signatur ein: Gehen Sie zu Online Store > Preferences in Ihrem Shopify-Adminbereich, scrollen Sie zu Crawler Access und erstellen Sie eine neue Signatur. Vergeben Sie einen aussagekräftigen Namen, wählen Sie die Domain und legen Sie eine Laufzeit von höchstens drei Monaten fest. Shopify erzeugt drei Werte: Signature-Input, Signature und Signature-Agent. Diese fügen Sie in Screaming Frog unter Configuration > HTTP Headers als benutzerdefinierte HTTP-Header hinzu.
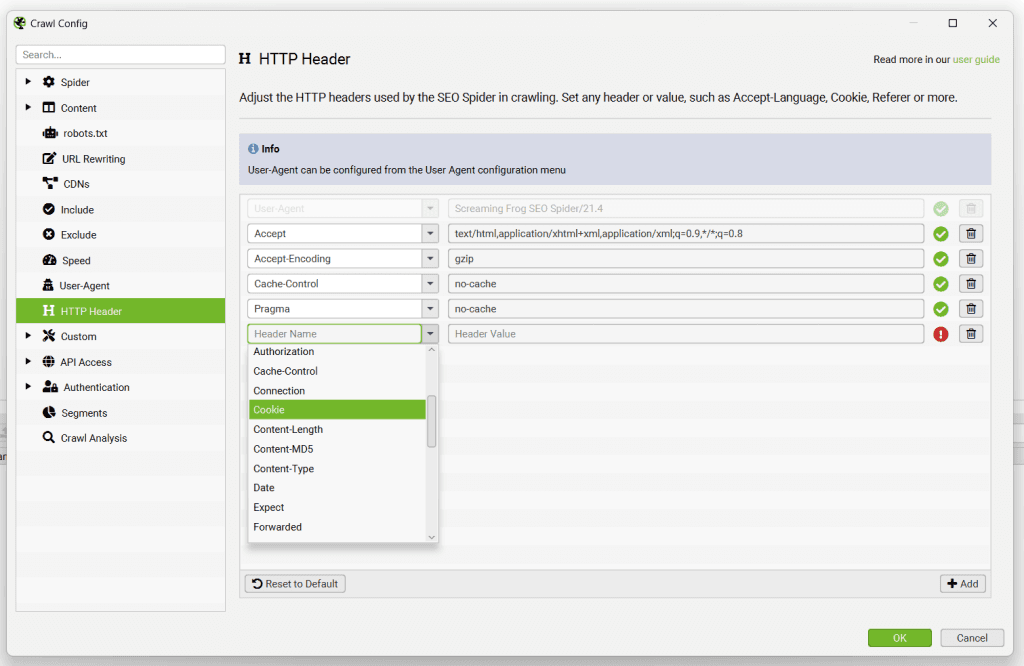
Jede Signatur gilt nur für eine Domain und läuft automatisch ab. Legen Sie sich eine Kalendererinnerung an, um sie alle drei Monate neu zu erzeugen. Und behandeln Sie die Werte wie Passwörter: Teilen Sie sie nicht in ungesicherten Dokumenten.
Flatline hat ausführlicher beschrieben, wie Web Bot Auth funktioniert und warum es für verlässliche SEO-Daten bei Shopify zählt.
Crawl-Geschwindigkeit begrenzen
Auch mit gültiger Signatur kann ein aggressiver Crawl den Shop unnötig belasten und das Risiko von Lücken in den Daten erhöhen. Drosseln Sie die Geschwindigkeit, gerade bei größeren Shops. Das Ergebnis sind sauberere und vollständigere Daten.

Diese Einstellung wird leicht übersehen. Ein langsamer Crawl, der sauber durchläuft, nützt mehr als ein schneller mit fehlenden Seiten. Treten nach dem Einrichten der Signatur weiterhin 429-Fehler auf, prüfen Sie als Nächstes die Crawl-Geschwindigkeit.
Das Shopify-CDN als intern festlegen
Shopify liefert Bilder, Skripte und andere Dateien über ein CDN mit eigener Domain-Struktur aus. Standardmäßig behandelt Screaming Frog diese als externe URLs. Sie fehlen dann in den internen Crawl-Daten oder werden separat gezählt.
Tragen Sie die CDN-Domain von Shopify in die Crawl-Konfiguration ein, werden diese Dateien als intern markiert. So sehen Sie genauer, was der Shop tatsächlich ausliefert und wie die Dateien mit den Seiten zusammenhängen.
Mehr aus Shopify herausholen mit Custom Search und Custom Extraction
Läuft der Basis-Crawl sauber, machen Custom Search und Custom Extraction Screaming Frog für Shopify-spezifische Analysen deutlich nützlicher.
Mit Custom Extraction ziehen Sie gezielt Daten aus allen Seiten auf einmal: Kollektionsbeschreibungen, Produktbeschreibungen und die Anzahl der Produkte pro Kollektion. Bei großen Sortimenten finden Sie so am schnellsten heraus, welche Kollektionsseiten zu wenig oder gar keinen Text haben und welche Produktseiten zu kurze oder doppelte Beschreibungen haben.
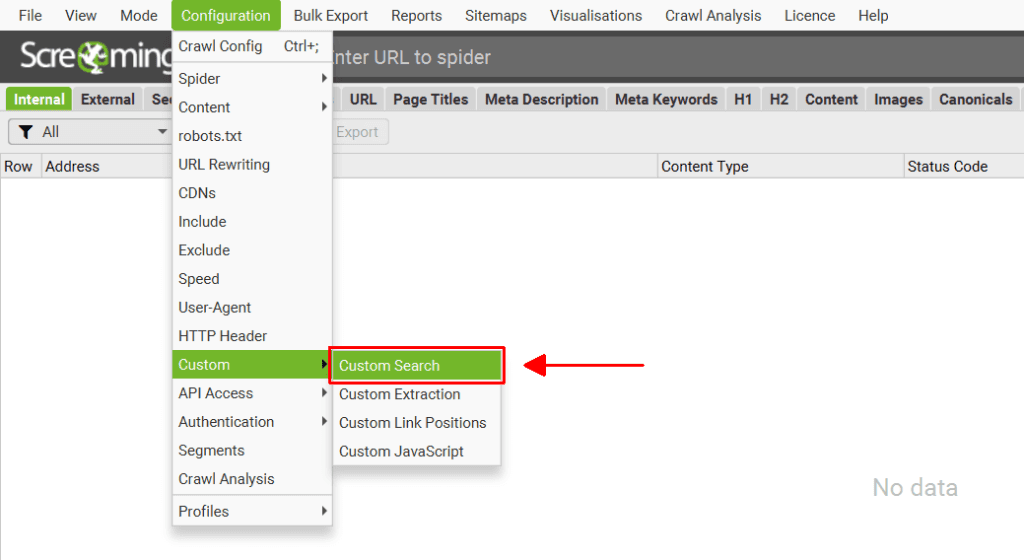
Custom Search funktioniert anders: Es durchsucht Seiteninhalte nach bestimmten Zeichenfolgen. In Shopify-Shops finden Sie damit etwa alle Produktseiten mit einem Ausverkauft-Hinweis. Oder Sie prüfen, ob die Ziel-Keywords auf den Kollektions- und Produktseiten stehen, die dafür ranken sollen.
Den Crawl-Umfang festlegen: Was gehört hinein, was nicht?
Ein Crawl ohne klaren Umfang erzeugt eine Datenflut. Mehr URLs bedeuten nicht mehr Erkenntnis, oft ist es umgekehrt. Diese drei Entscheidungen bestimmen, was der Crawl tatsächlich abdeckt.
XML-Sitemap crawlen, um Indexierungslücken zu finden
Wenn Sie bei der XML-Sitemap starten, sehen Sie, was Shopify aktiv an Suchmaschinen übermittelt. Wichtiger noch: Sie sehen die Lücken. Etwa verwaiste Seiten, die live und indexierbar sind, aber intern nicht mehr verlinkt werden, und URLs, die sich im Lauf der Zeit von der Hauptstruktur entfernt haben.
Eine Seite kann in den Suchergebnissen auftauchen, ohne Besuchern auf ihrem Weg durch den Shop etwas zu bringen. Der Sitemap-Crawl macht solche Seiten sichtbar.
Weiterleitungen folgen, um Umwege aufzudecken
Folgen Sie Weiterleitungen, sehen Sie, wo Anfragen tatsächlich landen. Sie finden Weiterleitungsketten, alte Pfade aus früheren URL-Strukturen und überflüssige Zwischenschritte, die Ladezeit kosten und Crawl-Budget verschwenden. Das sammelt sich vor allem in Shopify-Shops an, die Produktmigrationen, URL-Änderungen oder einen Umbau hinter sich haben.
Externe URLs ausschließen, um Rauschen zu vermeiden
Wenn Sie den Shopify-Shop selbst prüfen wollen, beschränken Sie den Crawl auf interne URLs. Externe Links zu crawlen erzeugt Rauschen, verlangsamt den Prozess und liefert Daten, die mit der Struktur oder der SEO-Leistung Ihres Shops nichts zu tun haben.
Häufige SEO-Probleme in Shopify, die ein Screaming-Frog-Crawl aufdeckt
Diese Probleme tauchen in Shopify-Shops immer wieder auf, unabhängig von Größe oder Branche. Ein gut konfigurierter Crawl zeigt auf einen Blick, wo sie stecken, auch bei Tausenden Seiten.
Problem | Auswirkung auf SEO |
Doppelte Inhalte bei Produkten und Kollektionen | Schwächere Rankings, weil Suchmaschinen die Signale auf doppelte URLs verteilen |
Defekte interne Links | Verschwendetes Crawl-Budget und höhere Absprungraten durch Sackgassen |
Dünne oder fehlende Kollektionstexte | Schwache Signale auf Kategorieebene, sodass Kollektionen nicht für kommerzielle Suchbegriffe ranken |
Doppelte oder fehlende Metadaten | Niedrigere Klickraten aus den Suchergebnissen, auf Hunderten Seiten zugleich |
Canonical-Fehler und ungewolltes Noindex | Seiten fallen aus dem Index, ohne dass das Team es merkt |
Doppelte Inhalte bei Kollektionen und Produkten
Durch die URL-Struktur von Shopify kann dasselbe Produkt über mehrere Pfade erreichbar sein, vor allem wenn es in mehreren Kollektionen vorkommt. Regeln Canonical-Tags das nicht korrekt, verteilen Suchmaschinen die Ranking-Signale auf mehrere Versionen derselben Seite. Jede einzelne verliert dadurch an Gewicht.
Dünne oder fehlende Kollektionstexte
Kollektionsseiten sind oft die kommerziell wichtigsten Landing Pages eines Shopify-Shops, denn hier landet der Suchtraffic auf Kategorieebene. Zeigen diese Seiten nur ein Produktraster ohne begleitenden Text, geben sie Suchmaschinen kaum Anhaltspunkte für ihre Relevanz. Mit Custom Extraction in Screaming Frog lesen Sie alle Kollektionsbeschreibungen auf einmal aus und sehen schnell, welche Seiten bessere Inhalte brauchen.
Defekte interne Links
Produkte werden entfernt. Kollektionen werden umgebaut. URLs ändern sich. Jedes Mal bleiben defekte interne Links zurück, die Besucher und Suchmaschinen-Crawler in Sackgassen schicken. Ein Crawl zeigt jeden defekten Link zusammen mit der URL, auf der er steht. So beheben Sie sie gesammelt, und das geht deutlich schneller als eine Prüfung von Hand.
Schwache oder doppelte Metadaten
Title-Tags und Meta-Descriptions, die aus den Produkt-Templates von Shopify entstehen, folgen oft über Hunderte Seiten demselben Muster. Das Ergebnis sind doppelte Metadaten in großem Stil. Das senkt die Klickraten, und in den Suchergebnissen hebt sich keine Seite mehr von den anderen ab.
Canonical-Fehler und ungewolltes Noindex
Falsche Canonical-Tags können dazu führen, dass Seiten Ranking-Signale verlieren oder ganz aus dem Index fallen. Noindex-Tags, die während der Entwicklung gesetzt und nie entfernt wurden, sind eine häufige Ursache für Indexierungslücken in Shopify-Shops. Diese Seiten sind live und technisch erreichbar, für Suchmaschinen aber unsichtbar.
Screaming-Frog-Daten mit der Performance verknüpfen
Technisches SEO ohne kommerziellen Kontext führt zu falschen Prioritäten. Eine nach Häufigkeit sortierte Liste von Crawl-Fehlern sagt nichts darüber, welche Probleme Sie zuerst angehen sollten.
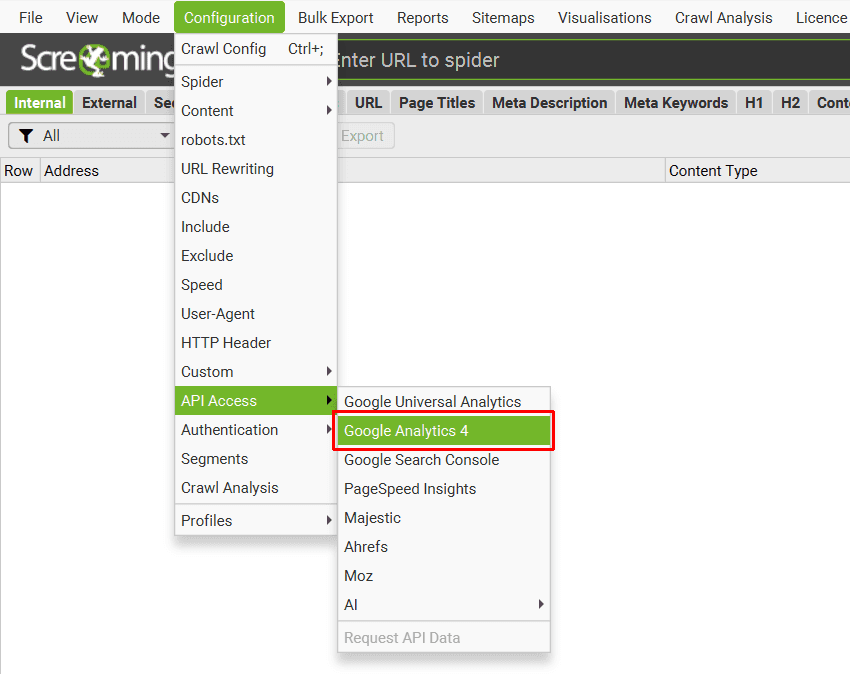
Verbinden Sie Screaming Frog mit der Google Search Console, erhalten Sie Klicks, Impressionen und Suchanfragen auf Seitenebene. Ein Metadatenproblem auf einer Seite mit 3.000 Impressionen im Monat hat eine andere Priorität als dasselbe Problem auf einer Seite, die nirgends sichtbar ist.
Mit GA4 legen Sie Umsatz, Conversion-Rate und Engagement-Kennzahlen über den Crawl. So konzentriert sich das Audit auf Seiten, die kommerziell etwas bewirken, und nicht nur auf Seiten, die technisch unvollkommen sind. Lighthouse-Daten ergänzen das um Signale zu Performance und Page Experience, vor allem wenn Geschwindigkeit oder Rendering Teil der Prüfung sind.
Erst die Kombination aus Crawl-Daten, Search Console und GA4 macht aus einem technischen Audit einen Maßnahmenplan mit klarer Reihenfolge. Ohne sie optimieren Sie nach der Zahl der Fehler statt nach der Wirkung auf Ihr Geschäft.
Wie Flatline technische SEO-Audits für Shopify angeht
Bei Flatline ist ein Screaming-Frog-Crawl nie das Endergebnis. Er ist der Ausgangspunkt, um Wachstumschancen in SEO, CRO und Website-Architektur zu finden.
Bei den Shopify-Shops, mit denen wir im Rahmen unserer E-Commerce-Leistungen arbeiten, zeigt sich immer wieder dasselbe Muster: strukturelle Probleme, die sich still im Hintergrund aufgebaut haben, während das Team mit Kampagnen, Produktlaunches und Frontend-Updates beschäftigt war. Ein Crawl macht sie sichtbar und zeigt dem Team klar, was zu beheben ist und in welcher Reihenfolge.
Nach einem Crawl-Audit für Shopify gehen wir in dieser Reihenfolge vor:
Indexierungsprobleme: Seiten, die fälschlich nicht in der Suche erscheinen
Defekte Links: verschwendetes Crawl-Budget und Sackgassen für Besucher beseitigen
Doppelte Inhalte: verwässerte Ranking-Signale bündeln
Metadaten: Klickraten auf Produkt- und Kollektionsseiten verbessern
Inhaltliche Tiefe: Kollektions- und Produktseiten stärken
Diese Reihenfolge gleichen wir immer mit dem kommerziellen Kontext ab. Seiten, die Umsatz bringen, kommen zuerst dran.
Als zertifizierter Shopify Platinum Partner arbeitet Flatline mit E-Commerce-Teams, für die SEO ein Wachstumskanal sein soll und keine Pflicht-Checkliste. Deshalb verbinden wir Crawl-Erkenntnisse mit Analytics, CRO-Daten und einer Prüfung der Website-Architektur. So entstehen Empfehlungen, die direkt auf Geschäftsergebnisse einzahlen.
Wollen Sie wissen, was Ihr Shopify-Shop verbirgt?
Screaming Frog zeigt Ihnen übersichtlich, wie Suchmaschinen Ihren Shopify-Shop sehen. Wie scharf dieses Bild ist, hängt aber von der Einrichtung ab.
Web-Bot-Auth-Signaturen, eine gedrosselte Crawl-Geschwindigkeit, die richtige CDN-Konfiguration und ein klarer Umfang sind keine optionalen Extras. Sie machen den Unterschied zwischen einem verlässlichen Audit und einem Haufen unvollständiger Daten. Und erst die Verknüpfung mit Search Console und GA4 macht aus dem Audit etwas, mit dem Sie arbeiten können.
Mit Shopify sind Sie schnell live. Die SEO-Basis Ihres Shops stabil zu halten, während das Sortiment wächst, verlangt eine andere Art von Aufmerksamkeit. Sie beginnt damit, zu sehen, was tatsächlich da ist.
Flatline führt technische SEO-Audits durch, die Crawl-Daten mit Analytics und CRO-Kontext verbinden. So beheben Sie, was Ihre Rankings wirklich voranbringt, und nicht nur, was einen Bericht füllt.
Nehmen Sie Kontakt auf, um über Ihren Shop zu sprechen.
Verwandte Artikel


